
Sommaire
Un tour des méthodes de dev hard/soft
Imaginons ce qui marchera en entreprise demain, avec l'ensemble de ce qui est le plus utile aujourd'hui. L’itératif est une évidence. Je vais faire un tour des méthodes incrémentales et retenir ce qui a fonctionné. Le texte ressemble un peu trop à une liste parfois. Le but est aussi d'avoir des points d'entrée pour faire des recherches plus approfondies.
1. Simplifier l'ingénierie système
Dans une équipe qui développe à la fois du logiciel et du matériel, les difficultés prennent des formes très différentes : une carte attend sa fabrication, une fonctionnalité attend une spécification, un défaut apparaît à l’intégration. Comment organiser ce travail pour livrer le maximum de valeur au final ?
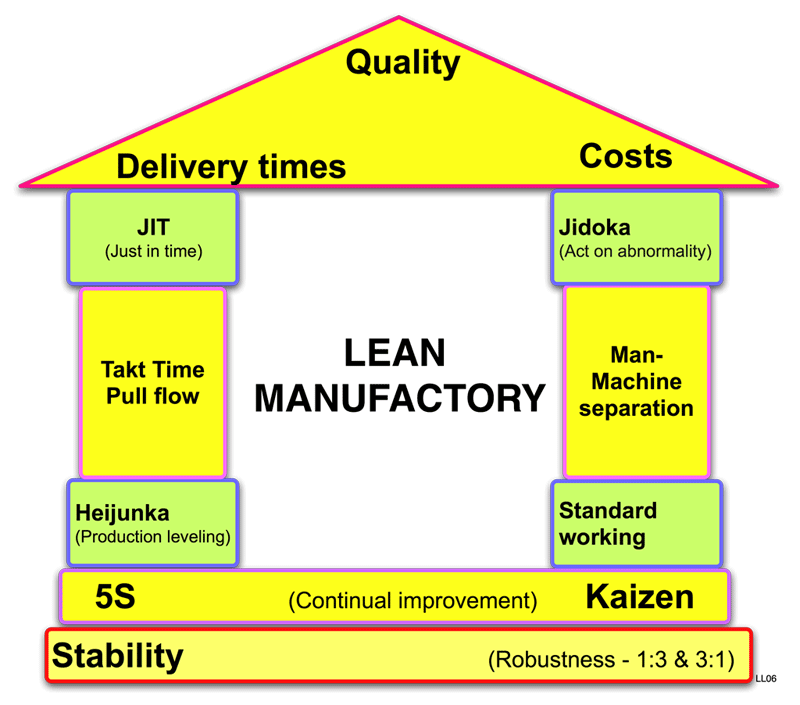
Le Lean de Toyota est toujours d’actualité surtout dans la fabrication (5S, SMED et Jidoka).
- 5S : Méthode d’organisation du poste de travail pour réduire le désordre et les pertes :
Trier, Ranger, Nettoyer, Standardiser, Maintenir. - SMED (Single Minute Exchange of Die) : Méthode pour réduire le temps de changement de série (réglages, outillage), idéalement à moins de 10 minutes, afin d’augmenter la flexibilité de la chaîne de production.
- Jidoka : Principe d’autonomation : la machine ou l’opérateur arrête le processus dès qu’une anomalie apparaît, pour éviter de produire des défauts. Ce principe est appliqué quand il s’agit de réparer une fois pour toutes une branche principale qui est trop souvent en défaut, quitte à le faire en mob programming.
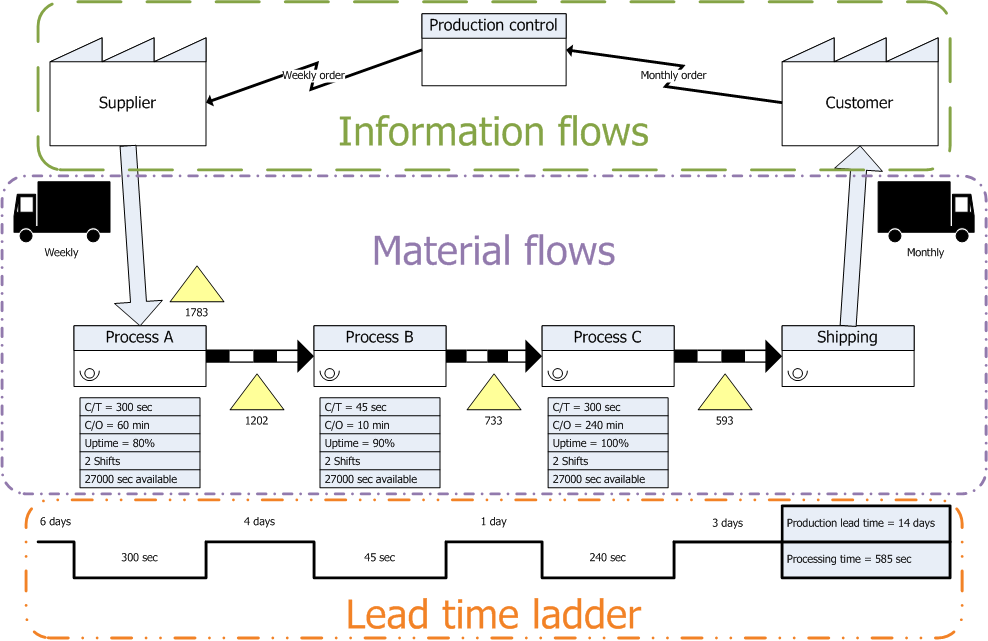
La Value Stream Mapping est une méthode de cartographie d'un processus ou d'un produit, qui inclut les flux, les stocks et les durées. Elle permet ensuite de faire la chasse aux gaspillages. C'est un des outils du Lean. Il n'est pas rare de trouver que 3/4 du temps n'est pas passé sur de la valeur ajoutée. Il faut partir du terrain pour partir des processus concrets.
L'Algorithme de Musk (Elon) est une méthode de management en 5 étapes pour résoudre des problèmes industriels :
- Remettre en question les exigences : ce qui implique d'avoir le nom de la personne et non le département pour pouvoir en discuter et la faire évoluer
- Éliminer toutes les parties éliminables du processus technique : vous pouvez les réintégrer plus tard, si vous n'en réintégrez pas 10 %, c'est que vous n'en avez pas assez éliminé.
- Simplifier et optimiser : à faire après l'étape 2, optimiser un processus ou une pièce qui ne devrait pas exister est une erreur.
- Raccourcir les cycles : uniquement après les étapes précédentes.
- Automatiser : à faire uniquement en dernier, après avoir supprimé tout ce qui peut l'être.
Le but est de ne pas faire de travaux inutiles.
L'ingénierie des systèmes est une méthode top-down de découpage d'un problème plus grand. Elle évite l'overdesign de l'approche bottom-up, mais elle nécessite de l'outillage car on manipule longtemps des "boîtes vides". Cette méthodologie est souvent liée à la technologie Eclipse EMF mais ne se résume pas à ça. On peut voir aussi l'usage de SysML, un dérivé d'UML (donc souvent complexe à manier). D’autres environnements propriétaires existent autour de SysML v2,
sa syntaxe textuelle et son API standard ouvrent la voie à des outils plus interopérables (en théorie).
Selon la vision classique, le cycle en V impose normalement de finir chaque étape avant de passer à la suivante. Ce qui n'est jamais fait. Le cycle en V a été défini pour décrire le "cycle en W" qui inclut une phase exploratoire, une première itération. Dès 1970, dans un article issu de son expérience des logiciels de missions spatiales, Winston Royce expliquait qu’un développement purement séquentiel était risqué et recommandait une première réalisation préparatoire avant le développement final. Le V met ensuite en évidence la correspondance entre chaque niveau de définition et son niveau de vérification ou de validation lors de l’intégration. Il décrit donc moins l’interdiction d’itérer que la nécessité de préparer, dès la descente, les preuves attendues pendant la remontée. C'est ce qui est souvent oublié par les développements contemporains.
2. Adapter l’agilité au logiciel et au matériel
Après le manifeste agile de 2001, le Scrum a eu son heure de gloire. Il ne faut d'ailleurs pas confondre Agilité et Scrum. C'est un cadre qui fait des choix fixes que n'ont pas à faire les équipes. Depuis le Scrum des années 2000, l’agilité a fait ses preuves mais a aussi évolué.
La tendance est à la simplification des rigidités de SCRUM, et au passage à l'échelle. À la souplesse, se rajoutent des points de repère qui permettent de rythmer le développement : la clôture des tickets, le “time boxing” d’un sprint, ou la production d’un document. L’idée est d’avoir une méthode définie pour ne pas trop se poser de questions au jour le jour et d’innover à l’intérieur du cadre, quitte à le modifier s'il devient un problème. Le cadre doit être adapté à chaque situation particulière de la société. C’est souvent ce qui est oublié dans les applications du modèle Spotify exposé en 2012.
Shape-up, issue de Basecamp, une startup de 50 personnes, a publié un livre en 2019 qui a eu beaucoup de succès. Cette méthode propose une étape de shaping/conception/définition de fonctionnalité, en parallèle avec 6 semaines de développement jusqu'à la mise en production par une équipe de dev, puis 2 semaines de cool-down. L'idée est de définir l'attractivité ("appetit") d'une fonctionnalité, ce qui détermine un temps de développement souhaitable par rapport à la valeur estimée, et l'équipe trouve une solution bornée dans ce temps donné. Le but est de ne pas gaspiller du temps.
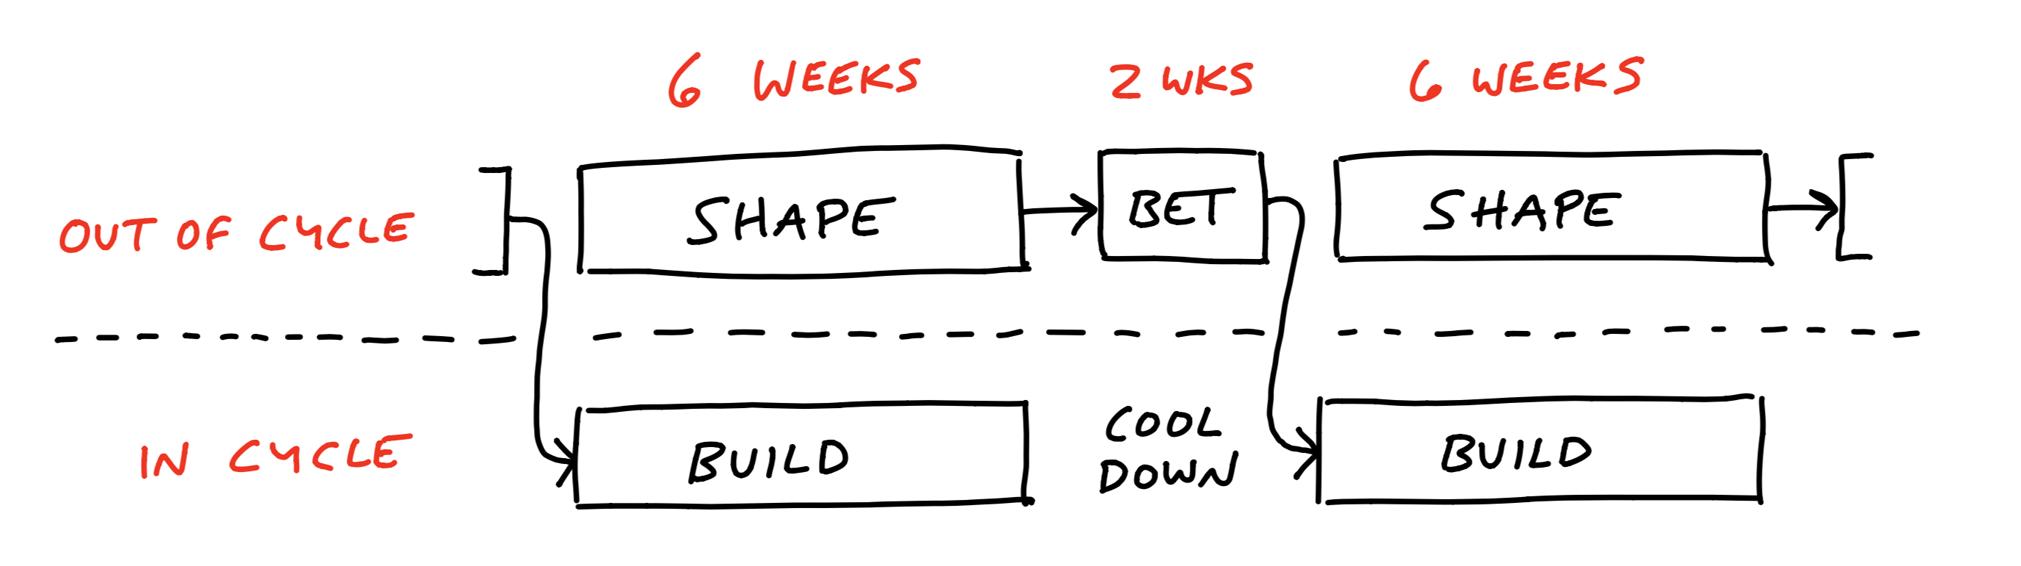
Le développement incrémental appliqué au logiciel n'est pas directement applicable à l'industriel. Il y a un calendrier supplémentaire lié aux livraisons hardware, en parallèle du développement des tâches.
Je note aussi l'eXtreme Manufacturing (https://en.wikipedia.org/wiki/EXtreme_Manufacturing ) de 2010 qui est intéressant car c’est issu d’un projet de création de voiture basse consommation pour un concours (Wikispeed arrivé 10e dans sa catégorie). Le leader du projet a adapté les concepts agiles pour le hardware, ce qui nous intéresse au premier plan. Il est ensuite passé chez Tesla. La modularité extrême et le “contract-first” ont retenu mon attention.
- Optimize for change,
- Object-oriented, architecture modulaire,
- Test-driven development.
- Contract-first design (API/interface en premier, ce qui facilite l'évolution du module)
- Iterate the design,
- Agile hardware design patterns
- Continuous integration development,
- Continuous deployment development
- Scaling patterns
- Partner patterns
Chez Tesla, Joe Justice a retenu un des outils, le "Justice Board". C'est un tableau dynamique, non pas de tâches, mais de métriques à améliorer. Chaque ligne comporte le nom du module concerné (ex. : siège), une métrique cible (ex. : masse 13 kg), les métriques à ne pas détériorer (coût 420 €, montage 42 s) et un chiffrage de l'impact pour montrer les priorités. Chaque semaine, une équipe de 3 à 5 personnes se monte pour améliorer un module directement sur la chaîne de production. Les modules sont suffisamment découpés pour ne pas avoir de handoffs dus à l'attente d'une autre équipe.
Le tableau met en évidence les contraintes qui limitent la performance globale : par exemple, un banc limité à 3 tests par jour alors que les étapes en amont et en aval peuvent traiter 12 unités. Les équipes choisissent les améliorations auxquelles elles peuvent contribuer, en respectant les autres métriques à ne pas dégrader. C'est une sorte de gamification du management, chacun décidant ce qu'il peut apporter de mieux à l'entreprise. Les équipes sont très autonomes, même financièrement. Il n'est pas clair que l'outil soit à la fois utilisé en production et en design. Mais il fait ressortir des métriques directement utiles à l'amélioration du produit.
Pour Joe, le "Hardware is not the bottleneck" : ce sont tous les cycles de décision en dehors de la boucle de développement qui font attendre.
“This would not work here,” they often mean, “I am not allowed to change what blocks it.”
Sa vision est que chaque compétence se retrouve dans l'équipe produit plutôt que d'être éparpillée dans plusieurs services. Mais pas seulement. L'architecture même du produit doit permettre cette indépendance. Chaque module doit pouvoir évoluer sans obliger les autres à évoluer aussi. On retrouve les règles de l'XM. L’autonomie demande à la fois les compétences, le pouvoir de décision et des interfaces techniques qui permettent de modifier un module sans entraîner tout le produit.
Le Kanban est toujours d'actualité. Il se focalise sur le rythme de livraison en limitant le travail en cours. On ne commence pas un travail sans avoir toutes les entrées ou ressources. Plus exactement, on "tire" le travail quand la capacité le permet. On travaille avec un flux visible. La "Definition of DONE" est clairement posée. On mesure les temps pour s'améliorer (en séparant blocage/attente et travail). On maximise la capacité du système à terminer régulièrement du travail utile, et on ne maximise pas l’occupation de chaque personne. C'est une méthodologie particulièrement intéressante lorsque le temps calendaire d'un développement est très supérieur au temps de travail effectif, à cause des fabrications, achats, essais et dépendances.
3. Donner aux équipes la maîtrise du produit
Une méthode de travail prend vie dans des équipes. Leur structure détermine les possibles, et l'efficacité au quotidien.
Par exemple, la conway law : « Toute organisation qui conçoit un système, au sens large, concevra une structure qui sera la copie de la structure de communication de l’organisation ». Logiquement, cela a poussé à introduire la reverse conway law qui implique d’organiser les équipes de développement en suivant la structure du logiciel que l’on veut écrire. Ou comment 4 équipes fabriquent un compilateur en 4 passes.
Le livre Team Topologies a tiré un bilan de ce qui est efficace, en 2019, en croisant avec des recherches en sociologie. On retient leur définition de 4 types d'équipe qui collaborent.
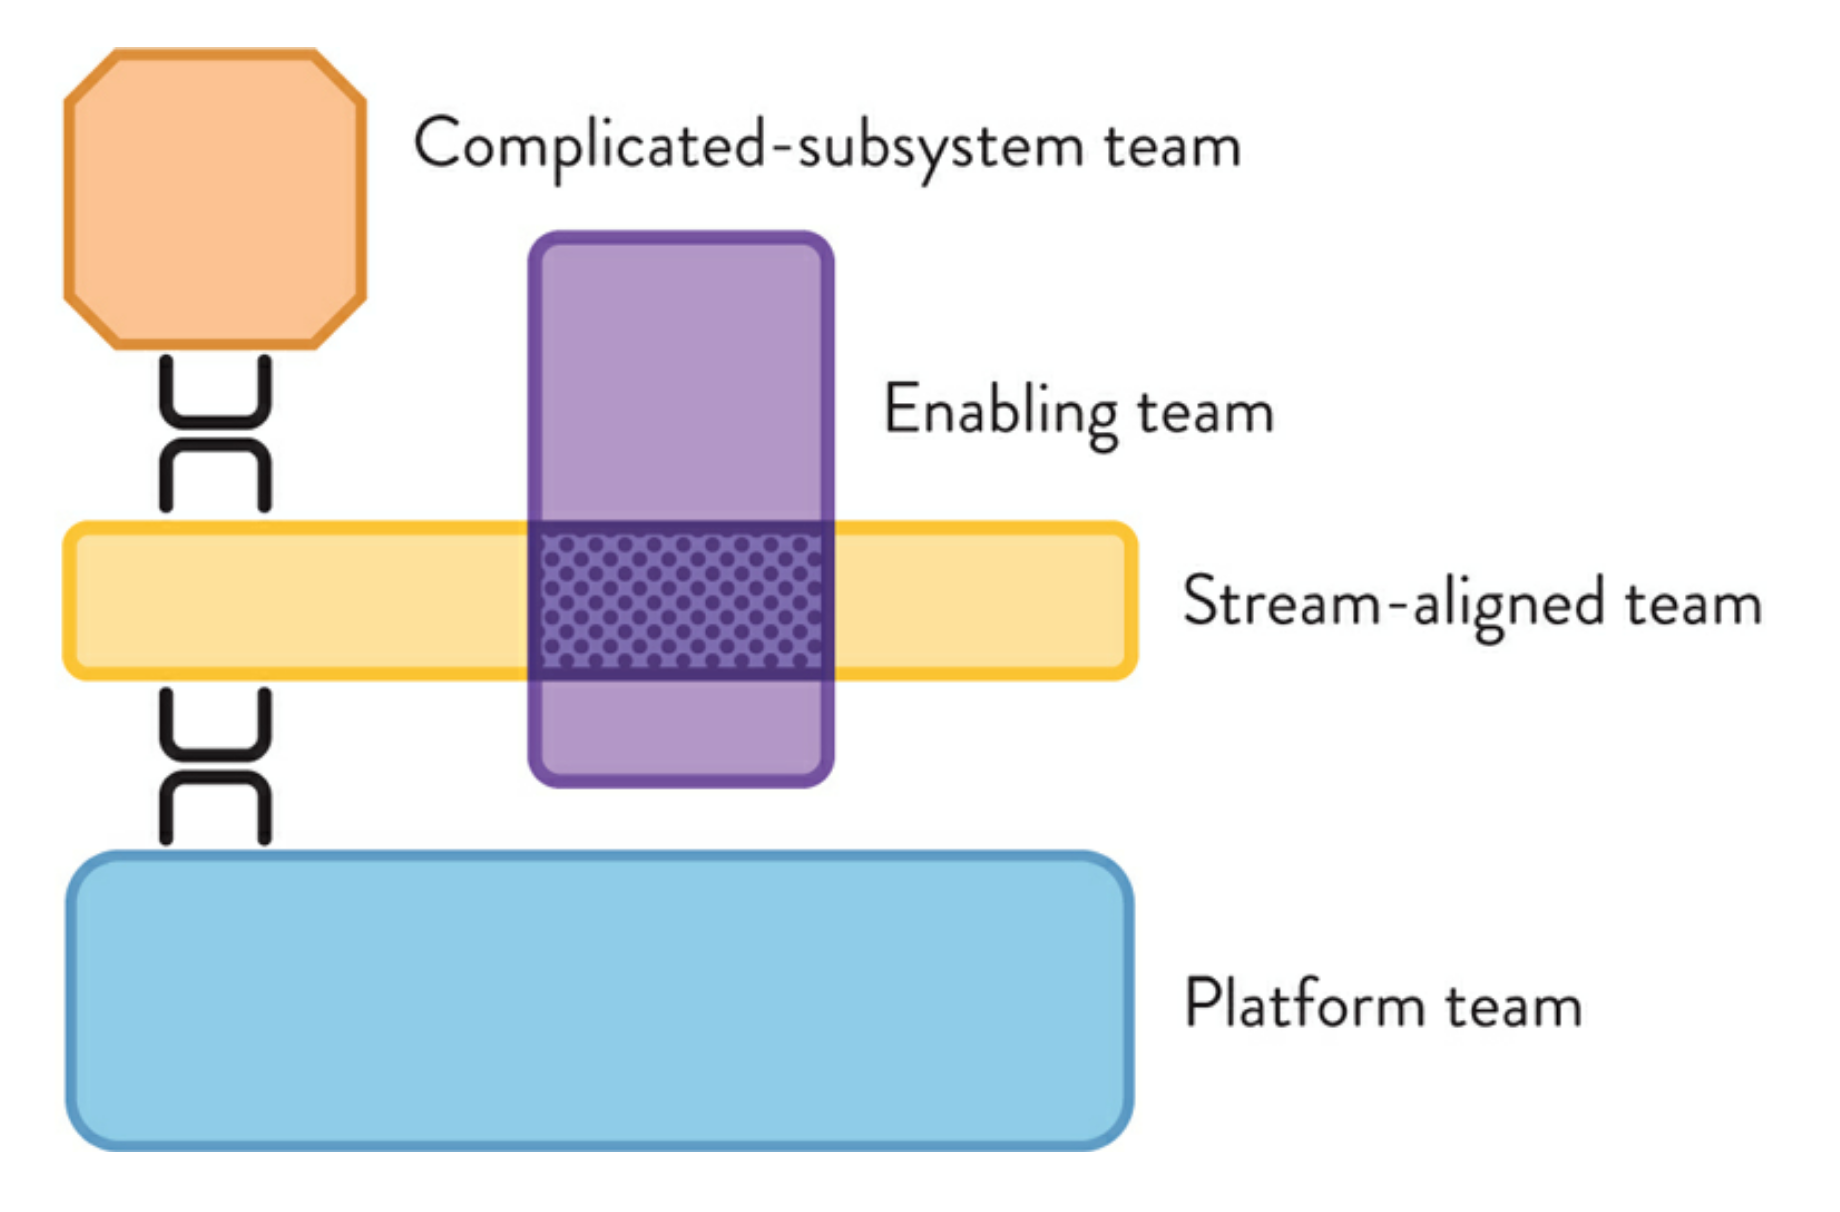
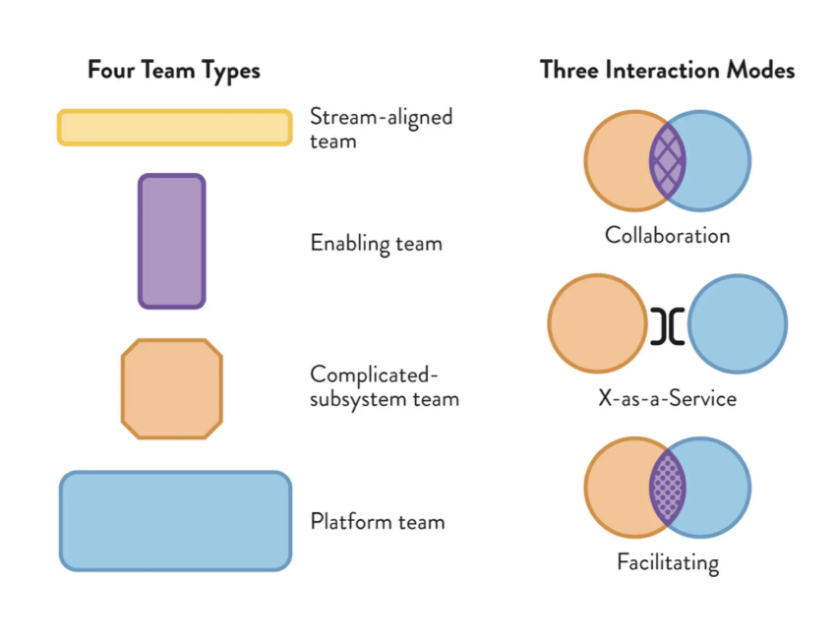
La méthode définit que les tâches sont confiées à une équipe et pas à un individu. Sinon, les objectifs individuels peuvent aller contre l’intérêt de l'équipe. Les équipes doivent être construites pour diminuer la “quantité de choses à connaître” et éviter de perdre du temps lors des changements de tâches. Ils insistent aussi sur une organisation qui supprime les "handoff" car ces attentes vont augmenter avec l'augmentation du nombre d'équipes : ce qui ne passe pas du tout à l'échelle.
Des recherches en sociologie ont conforté les tailles d'équipes autour de 6 (max 9 personnes) et de services de 35 personnes qui correspondent au nombre de personnes que l’on peut “bien” connaître.
La tendance organisationnelle est plus aux tranches ("slices") qu’aux couches. Une équipe est responsable d’un morceau de site web de A à Z devant les clients en partant des allocations des machines, base de données, frontend, administration. C’est la méthode suivie par Facebook. Il y a une maîtrise de bout en bout avec une confrontation avec le vrai client qui paie. Il est impossible de “faire son boulot” en lançant son travail à l'équipe suivante (non-qualité observée chez Renault dans les années 2000, cela rebouclait indéfiniment entre services après une non-qualité observée à la fin du pipeline). Faire son travail “by the book” n’est pas suffisant.
L’idée de "Discovery continue" (Teresa Torres) est de ne pas faire une grosse phase de découverte au début du projet puis passer définitivement en delivery. C'est une autre façon de définir l'itératif.
Une équipe R&D moderne ne doit pas seulement livrer vite ; elle doit vérifier en continu que ce qu’elle livre répond à un vrai problème client. La discovery continue consiste à maintenir un contact régulier avec les utilisateurs par l'équipe de dev, formuler les hypothèses produits, tester les risques tôt par prototypes, interviews, mesures terrain ou essais, puis alimenter le backlog avec des décisions fondées sur des preuves. La Discovery se distingue de la Delivery : décider ce qui va être construit par rapport à sa construction propre. Mais c'est la même équipe qui fait les 2 pour avoir tout le contexte et ne pas faire de travail inutile.
4. Concevoir pour durer et produire
Concevoir pour durer, c’est permettre au produit d’évoluer sans accumuler de complexité ; concevoir pour produire, c’est anticiper sa fabrication et ses tests.
Il existe aujourd'hui beaucoup de propositions d'organisation de son code pour ne pas créer de dettes techniques, et faciliter sa modification dans le temps. Développer un nouveau code est rapide, mais si on doit tenir compte de toutes les fonctionnalités précédentes pour développer les nouvelles, en prenant une métaphore algorithmique, on développe en o(n) et non plus en o(1). La vitesse de développement ne fait que décroître.
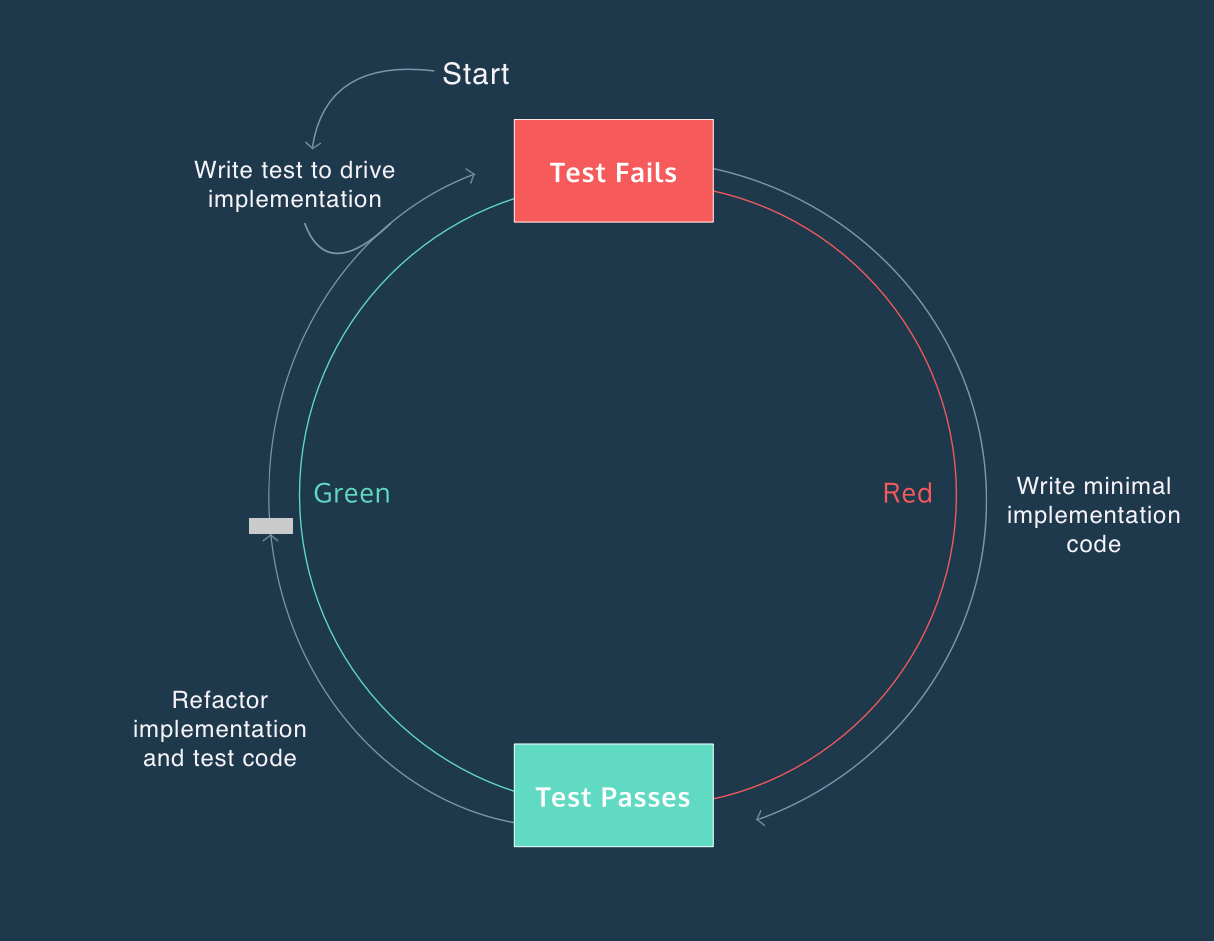
Le craft ou software craftsmanship définit de bonnes pratiques. Le TDD demande d'écrire le test avant le code. Cela permet de simplifier les tâches à faire en évitant l’overdesign et évite aussi d’avoir un test complexe à écrire plus tard. La méthode Red, Green, Refactor propose une méthodologie vertueuse d'écriture du code.
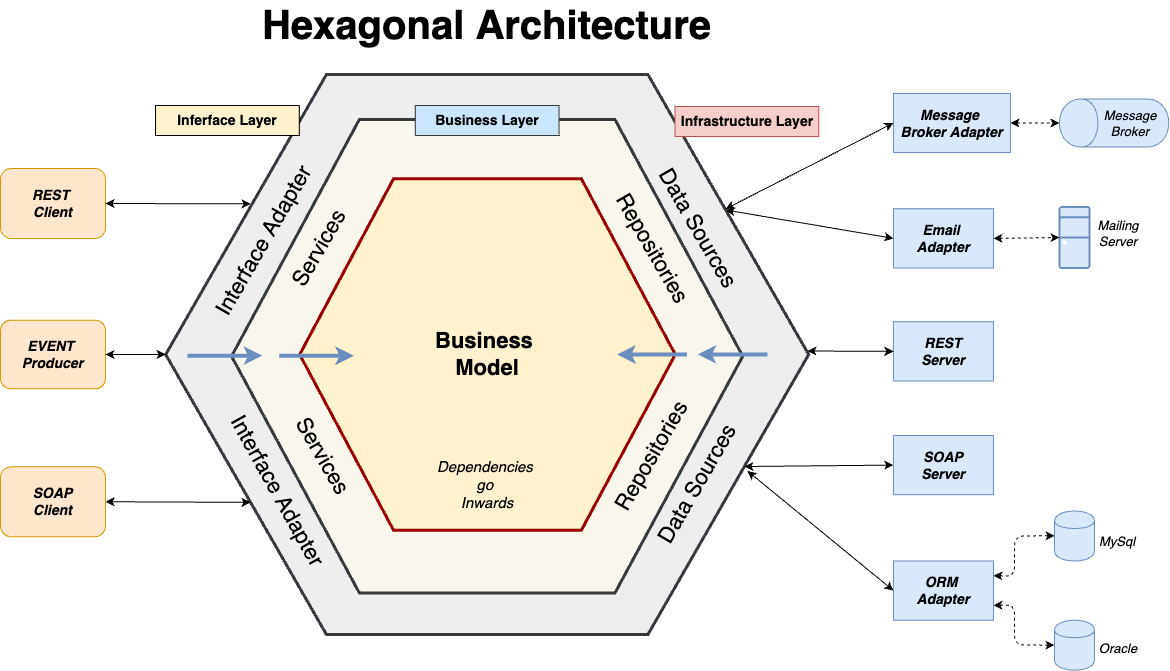
L’Architecture hexagonale est un patron d’architecture qui répond à la problématique d’un code métier qui peut vieillir sur des décennies au contraire d’interfaces graphiques qui deviennent obsolètes beaucoup plus rapidement. Le principe est de briser la dépendance entre les 2. Le code métier devient central et propose des interfaces qui sont implémentées par du code dont la durée de vie peut être plus courte. Il est toujours plus facile d’ajouter du code que de le modifier.
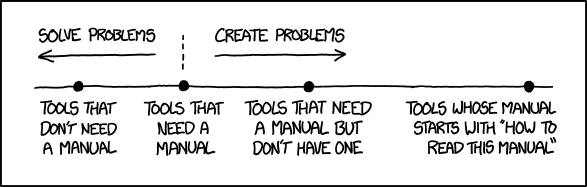
Pour certains, une grosse documentation est le signe d’un système beaucoup trop complexe avec un UX/CX (interface/expérience utilisateur ou développeur) non pensé.
"La perfection est atteinte, non pas lorsqu'il n'y a plus rien à ajouter, mais lorsqu'il n'y a plus rien à retirer." - Antoine de Saint-Exupéry.
Cette citation rappelle qu’il n’y a rien de plus compliqué que de faire simple. Chaque module de système doit être simple, compréhensible, sans surprise, pour être facilement réutilisé, et construire des systèmes encore plus grands. Si la complexité grimpe à chaque ajout, le système va vite être ingérable. On confond parfois simple avec petit. Un petit code peut être complexe mais rester compréhensible.
La tendance est aussi au “everything as code”. Infrastructure as code est le plus connu. Le but est de faciliter la reproduction de procédure. Un script est à jour ; sinon, il finira par planter. Ce n’est pas le cas d’une doc. Un document long, complet et bien fait est d’autant plus difficile à maintenir. L’avantage du code est qu’il est sans ambiguïté et ne devient pas obsolète facilement.
Écrire une spécification complète et cohérente est souvent un boulot à part entière qui peut être un livrable d'une tâche. Un Architecture decision record est un log immuable des décisions prises. Il ne peut pas devenir obsolète car il capture les choix, l'environnement et les besoins de l'instant. C'est beaucoup plus léger qu'une spec et cela porte un peu plus d'information (typiquement pourquoi on écarte les autres choix). Et surtout, cela n'est jamais obsolète.
Un prototype qui fonctionne laisse encore plusieurs questions ouvertes : comment le fabriquer régulièrement et vérifier chaque exemplaire ? Tout se simplifie si ces questions sont prises en compte dès la conception.
Comme il existe un "design for test" qui facilite le test logiciel en adaptant l'application, il y a le DFM (Design for Manufacturing) pour faciliter et fiabiliser la fabrication (ex. : composants en multi-source), le DFA (Design for Assembly) pour simplifier le montage mécanique (moins de pièces, moins de vis), le DFT (Design for Test) pour pouvoir vérifier rapidement qu'un produit fabriqué fonctionne (points de test, etc.). Le FMEA (ou en français AMDEC, Analyse des modes de défaillance, de leurs effets et de leur criticité) définit pour chaque panne possible une protection ou une modification du design selon les conséquences. Le "plan de contrôle" est la liste des tests à faire à la production pour accepter un produit. Le SPC (Statistical Process Control) surveille des valeurs physiques à la fabrication, au lieu de faire seulement un go/nogo, pour détecter une dérive avant de produire des pièces hors tolérances (ex. : mesure de tension ou de courant).
Ce n'est pas une méthode en tant que telle, mais la cybersécurité est un domaine à prendre en compte qui ne peut plus être écarté comme un surcoût inutile. En 2010, on retrouvait dans l'embarqué les erreurs faites dans les serveurs dans les années 2000 (ex. : mot de passe root par défaut). Aujourd'hui, on retrouve ces erreurs dans les applications vibe-codées ou codées trop rapidement. Comme l'expérience autour des e-mails l'a démontré, on peut rarement sécuriser un projet à la fin d'une conception. La sécurité doit être pensée très en amont, surtout si on veut rester simple.
Quelques mois après un essai, il faut pouvoir retrouver des résultats, que ce soit pour un audit ou pour vérifier la présence ancienne d'un comportement remarqué récemment. Le DevOps a évolué pour intégrer la "Continuous Compliance / Continuous Assurance → Continuous Evidence". La "Continuous Evidence" impose de garder des preuves : horodater les essais, garder les rapports d'essais et les résultats obtenus. Le but est de toujours prouver que l'on est sur les bons rails.
5. Mesurer pour progresser
Comment évaluer son travail ? Faut-il prendre des KPI au risque qu'ils soient gamifiés et ne servent plus à rien (ex. : vitesse en points de sprint SCRUM, nombre de lignes modifiées, taux de couverture des tests, nombre de tickets clos) ?
Un chercheur a fait une étude dans des publications scientifiques concernant la question : "Est-il toujours moins coûteux de trouver un bug en amont ?" (https://buttondown.com/hillelwayne/archive/i-ing-hate-science/). Ses recherches montrent la complexité du sujet. Je retiens que la science n’a validé que peu de pratiques efficaces pour améliorer la qualité logicielle.
“Code review is good, fast feedback is good, sleep is good.”
On en déduit que les revues de code ou de document sont efficaces, que le principe de retour d’informations rapide au cœur de l’incrémental ou de l’agile l’est aussi, et que l'état d'éveil des développeurs est important pour la qualité (le "crunch" est donc peu efficace).
Every layer of review makes you 10x slower est un article récent qui rappelle qu'un code de 30 minutes est revu 5 h plus tard par un pair, et dans la semaine par un architecte. L'IA va réduire le temps d'écriture du code de 30 min à 3 min, mais les revues seront toujours là. L'auteur évoque le concept de "qualité totale" issu des constructeurs japonais : la qualité interne de chaque composant évite ensuite un gros effort de QA sur un ensemble plus grand. Cela permet de limiter les tests d'intégration. Le passage à l'échelle est donc beaucoup plus facile.
https://genehack.blog/2026/02/the-only-developer-productivity-metrics-that-matter/ est un petit article qui souligne qu’il est très difficile d’avoir un KPI dans la production de code. Il insiste pour n’utiliser que :
1. How often does the team *routinely* ship new versions of the software they build? - once a week

2. How often do things break when the team ships a new version? (production break) - never

3. (bonus) How often does a new version of the software the team builds spark actual joy in the people who have to use it? - at least one
DORA et SPACE sont deux ensembles de métriques. DORA (pour DevOps Research and Assessment) :
- Fréquence de déploiement : À quelle fréquence le code est-il mis à disposition pour la production ou libéré pour les utilisateurs finaux ?
- Délai pour les changements : Combien de temps faut-il entre l'écriture du code et son utilisation réussie dans la production ? Cela donne une idée de la latence pour une correction. (du commit à la production)
- Temps moyen de récupération (MTTR) : Combien de temps faut-il pour rétablir le service en cas d’incident de service après un déploiement ou de défaut affectant les utilisateurs ?
- Taux d’erreur lors des modifications : Quel est le pourcentage de changements dans la production ou les partages avec les utilisateurs qui entraînent une dégradation du service ou nécessitent une correction ultérieure ?
SPACE couvre satisfaction/bien-être de l'équipe de dev, performance, activité, communication/collaboration et efficacité/flux.
DevEx (Developer Experience) est plus orienté développeur et équipe. Il mesure la boucle de développement au sens large (spécification, code, build, test, détection d'erreur). Plus elle est rapide, plus le développement peut s'adapter. Il regarde aussi la réduction de la charge cognitive ("chose à connaître" de Team Topologies) pour que les développeurs se concentrent sur les problèmes à résoudre. Il insiste aussi sur le "flow". C'est un état de concentration intense très productif qui peut durer 2 à 3 h. La moindre interruption peut faire perdre 15 min avant de retourner dans cet état, ou non. C'est assez contre-intuitif pour les personnes qui gèrent leur temps par période d'une heure comme les administratifs, ou qui répondent beaucoup au téléphone ou rapidement aux e-mails. Il peut par exemple être utile de ne pas faire de réunion le matin.
Le travail suivant sera de trouver le meilleur compromis entre toutes ces propositions. Il faudra balancer entre le surcoût de travail induit et ce qu'elles apportent à une organisation actuelle.
Envoyer un commentaire
Suivre le flux des commentaires
Note : les commentaires appartiennent à celles et ceux qui les ont postés. Nous n’en sommes pas responsables.