
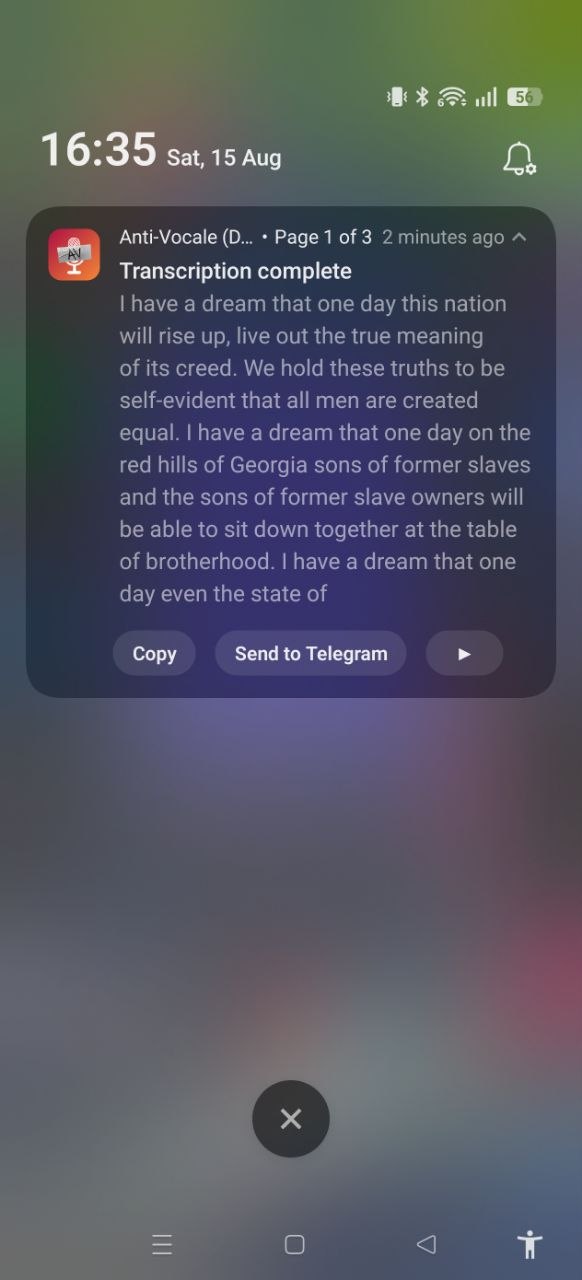
J'ai écrit une application Android qui transcrit les messages vocaux localement, sur le téléphone. Aucun fichier audio ne quitte l'appareil. On partage le vocal depuis WhatsApp ou Telegram, le texte arrive en notification et reste dans l'historique interne, avec recherche, copie, partage et export TXT/SRT/VTT.
La transcription intégrée de WhatsApp ne gère pas le français sur Android (en/pt/es/ru seulement, FAQ officielle). Cette application si, avec plusieurs modèles: un Canary Flash 180M en français (petit et rapide), Whisper et le Parakeet multilingue, plus un catalogue de modèles communautaires importables (allemand, ukrainien, russe, arabe…). Les fichiers vidéo sont pris en charge aussi.
Tout tourne sur l'appareil via sherpa-onnx et LiteRT: aucune donnée n'est envoyée. Logiciel libre (GPL), sans pub, sans traqueur. Sur F-Droid et Play Store, code sur GitHub. Le développement a été assisté par IA, c'est déclaré dans le README.
Vos retours sont les bienvenus, notamment sur les modèles à ajouter au catalogue pour d'autres langues.
Liens:
Play Store: https://play.google.com/store/apps/details?id=com.antivocale.app
F-Droid: https://f-droid.org/packages/com.antivocale.app/
Source: https://github.com/RisorseArtificiali/anti-vocale
# Pourquoi ce spam ?
Posté par Glandos . Évalué à 2 (+4/-4).
Je ne comprends pas très bien pourquoi ce spam.
L'application est bien vibe codée, ça fait 7 mois qu'elle existe d'après le dépôt Github.
D'après son profil, l'auteur a un blog, dont les articles semblent quand même bien sérieux, même si pas mis à jour depuis 2017 : https://giallone.blogspot.com/
Il a également une adresse email, j'imagine qu'on peut lui demander pourquoi il a fait ça ? Ou bien c'est de la perte de temps ?
[^] # Re: Pourquoi ce spam ?
Posté par Nicolas Boulay (site web personnel) . Évalué à 10 (+13/-3).
Pourquoi il fait quoi ?
Les site linuxfr ont toujours servi pour faire la promotion de logiciel open source. Le spam concerne les programmes privateurs.
Pourquoi condamner ce logiciel parce qu'il a un répertoire claude ? Pourquoi ce comportement anti-claude primaire ?
"La première sécurité est la liberté"
[^] # Re: Pourquoi ce spam ?
Posté par gUI (Mastodon) . Évalué à 10 (+8/-1).
Et justement c'est assez bien foutu, j'ai appris l'existence des hooks.
En théorie, la théorie et la pratique c'est pareil. En pratique c'est pas vrai.
[^] # Re: Pourquoi ce spam ?
Posté par Glandos . Évalué à 4 (+5/-3).
Hé bien oui, je me suis aussi posé la question en fait.
Le compte est tout neuf, le phrasé est digne d'une IA qui fait ça vite fait.
Visiblement, l'auteur est italien, il sait peut-être écrire en français. Mais là, ça manque de beaucoup de choses : se présenter, développer, etc.
[^] # Re: Pourquoi ce spam ?
Posté par zurvan . Évalué à 7 (+11/-6).
l'appli est libre, fonctionne bien et répond à un besoin (je déteste les gens qui envoient un vocal au lieu de rédiger un sms, donc ça va m'être pratique). Ça demande pas mal de ressources même sur mon smartphone android avec 8 Go de ram je suis obligé de quitter firefox pour faire une reconnaissance.
Au niveau de la présentation du logiciel, il me semble que tout est dit, c'est factuel et conçis.
Bref, pas du spam, et bien moins hors-sujet que 75% du contenu généralement posté ici.
"Ce n'est pas à l'état de tout savoir sur ses citoyens, mais au citoyen de tout savoir sur l'état."
[^] # Re: Pourquoi ce spam ?
Posté par Psychofox (Mastodon) . Évalué à 0 (+4/-7).
C'est à dire que linuxfr n'a jamais eu pour vocation d'être le nouveau freshmeat.net
[^] # Re: Pourquoi ce spam ?
Posté par Voltairine . Évalué à 1 (+5/-6).
Donc cela te convient de venir sur linuxfr.org pour lire des messages de promotion rédigés par des robots pour des applications codées par des robots.
[^] # Re: Pourquoi ce spam ?
Posté par zurvan . Évalué à -5 (+7/-14).
Je préfère effectivement les interventions des LLM plutôt que les tiennes
"Ce n'est pas à l'état de tout savoir sur ses citoyens, mais au citoyen de tout savoir sur l'état."
[^] # Re: Pourquoi ce spam ?
Posté par Nicolas Boulay (site web personnel) . Évalué à 4 (+7/-6).
On est ici pour le libre, le soft est libre.
"La première sécurité est la liberté"
[^] # Re: Pourquoi ce spam ?
Posté par Psychofox (Mastodon) . Évalué à 7 (+4/-0). Dernière modification le 25 septembre 2026 à 17:11.
Il y a des gens qui sont ici pour le libre, d'autres qui sont pour linux et s'en foutent, d'autres qui aiment bien le libre mais font de grosses concessions/entorses à leurs idéaux comme par exemple pour jouer à des jeux via steam, certains qui sont apparemment là uniquement pour troller, d'autres pour spammer ou promouvoir leur projet, etc, etc.
Le publique de Linuxfr est assez varié en fait, c'est dur pour parler au nom de tous (rien que sur le sujet de l'IA ça a l'air un peu 33-33% résolument pour ou contre et un autre tiers plus indécis ou ça dépend si c'est servi par bigtech ou si c'est bio.
[^] # Re: Pourquoi ce spam ?
Posté par Luc-Skywalker . Évalué à 3 (+1/-0).
Heureusement il ya:
LE KARMA
et c'est vaste …
"Si tous les cons volaient, il ferait nuit" F. Dard
[^] # Re: Pourquoi ce spam ?
Posté par Psychofox (Mastodon) . Évalué à 5 (+4/-2). Dernière modification le 25 septembre 2026 à 17:17.
Au final ce qui est triste c'est que le seul qui avait une question pertinente est complètement ignoré par
le spammeurl'agent IAle clunker qui a rédigé ce journal.[^] # Re: Pourquoi ce spam ?
Posté par zurvan . Évalué à 1 (+0/-1).
je n'ai pas vraiment compris ce que tu entends par "clunker" ("vieux truc qui fonctionne mal" ?), mais finalement cette question a quand été répondue quelques temps après. Bon, c'est une réponse 99 ou 100% rédigée par son LLM, et ça reste évidemment un peu froid…
"Ce n'est pas à l'état de tout savoir sur ses citoyens, mais au citoyen de tout savoir sur l'état."
[^] # Re: Pourquoi ce spam ?
Posté par hippocampe . Évalué à 10 (+9/-0). Dernière modification le 25 septembre 2026 à 16:11.
Sans Anti-Vocale, tu perds ton sang-froid ?
[^] # Re: Pourquoi ce spam ?
Posté par zurvan . Évalué à 4 (+2/-0).
exactement, trust me bro!
"Ce n'est pas à l'état de tout savoir sur ses citoyens, mais au citoyen de tout savoir sur l'état."
[^] # Re: Pourquoi ce spam ?
Posté par Benoit Sibaud (site web personnel) . Évalué à 5 (+2/-0).
Anti-focale tu perds ton s… qu'est-ce que je disais déjà ?
[^] # Re: Pourquoi ce spam ?
Posté par mrlem (site web personnel, Mastodon) . Évalué à 7 (+6/-0).
Pour moi ça dépend un peu :
Mon avis : à contenu égal, je considère le premier cas comme un spam, mais pas le second.
[^] # Re: Pourquoi ce spam ?
Posté par Christophe . Évalué à 10 (+11/-2).
C'est du spam, au sens où l'auteur du journal (qui n'existe peut-être même pas) ne viendra jamais répondre aux commentaires.
Donc c'est juste du publi-postage, sans aucun respect pour le public de linuxfr.org.
[^] # Re: Pourquoi ce spam ?
Posté par risorseartificiali . Évalué à 4 (+4/-0).
Merci pour le retour et pour les chiffres. La difficulté de ce genre d'application, c'est le nombre de dimensions qui conditionnent le résultat : le matériel, la charge du téléphone au moment de la reconnaissance, le modèle choisi, la longueur du message, et sans doute d'autres paramètres encore.
Un défi supplémentaire : la couche de transcription est sherpa-onnx, en C, et elle ne propage pas toujours ses erreurs à la couche Android ; elle peut échouer silencieusement. Je continue d'améliorer l'application pour tracer ces situations, les journaliser et les signaler à l'utilisateur, et je contribue aussi des correctifs au moteur en amont.
Je ne conteste pas votre constat, mais deux éléments de contexte. Jusqu'à la 1.13.0 incluse, un bug faisait surestimer la mémoire nécessaire au modèle et bloquait des reconnaissances que le téléphone aurait pu mener à bien ; c'est corrigé depuis, et le réglage de protection mémoire reste désactivable pour forcer un essai. Par ailleurs, des utilisateurs ont signalé réussir des transcriptions sur des téléphones à 3 ou 4 Go de RAM.
Si vous voulez expérimenter : Nemotron 0.6B int8 est le plus léger des modèles intégrés, le catalogue communautaire contient un Whisper Tiny multilingue étiqueté faible en mémoire, et dans les réglages vous pouvez désactiver la protection mémoire pour tenter un essai même quand l'application se montre prudente. Un ticket GitHub avec le modèle utilisé et la durée du vocal me permettrait de regarder votre cas précis.
[^] # Re: Pourquoi ce spam ?
Posté par mrlem (site web personnel, Mastodon) . Évalué à 3 (+2/-0).
Pour le pourquoi, je serais tenté par cette explication :
Il n'aura échappé à personne que le monde du travail pour les devs devient plus tendu en terme d'offre / demande dernièrement. Dans le monde des devs mobiles, avoir dans son CV une appli perso avec de nombreux téléchargements sur les stores permet de marquer des points.
[^] # Re: Pourquoi ce spam ?
Posté par Voltairine . Évalué à 0 (+1/-3).
Je pense au contraire que mettre en avant ce type d'application est contre productif.
[^] # Re: Pourquoi ce spam ?
Posté par risorseartificiali . Évalué à 2 (+2/-0).
Bonjour, et désolé pour le manque de réactivité : j'avais perdu de vue ce journal et je n'ai reçu aucune notification. J'y suis revenu aujourd'hui, presque par hasard.
Sur le débat soulevé par votre commentaire : en parcourant les autres journaux du site, j'avais compris qu'on pouvait y signaler des logiciels libres d'utilité publique. Si je me suis trompé, toutes mes excuses, et je n'ai aucun problème à ce que le journal soit supprimé ; ce n'était pas mon intention de créer des problèmes.
Je me présente : Paolo Antinori, ingénieur italien (github.com/paoloantinori). J'ai écrit cette application pour un usage personnel, je reçois beaucoup de messages vocaux et je préfère les lire. Le développement est assisté par IA, c'est déclaré dans le README ; ce journal aussi a été rédigé avec une aide IA, parce que je ne maîtrise pas assez le français pour l'écrire seul.
Si j'ai posté ici, c'est pour faire connaître l'application sur un canal francophone. Comme pour l'italien et l'allemand, la transcription intégrée de WhatsApp ne couvre pas le français, donc j'ai pensé qu'elle pouvait être utile ici ; elle a d'autres atouts, mais c'est la motivation de départ.
Je réponds maintenant aux questions techniques, en commençant par celle de jch.
[^] # Re: Pourquoi ce spam ?
Posté par Nicolas Boulay (site web personnel) . Évalué à 0 (+1/-4).
Il y a ici un peu de moins de 10 personnes anti-IA très actif qui descendent tout ce qui touche de prés ou de loin à un LLM. Il suffit de le mentionner dans son texte pour déclencher leur colère.
"La première sécurité est la liberté"
# Meilleurs modèles ?
Posté par jch . Évalué à 10 (+11/-0).
As-tu fait une comparaison des différents modèles de transcription ?
Si je demande, c'est à cause du logiciel de sous-titrage automatique de Galène, galene-stt. J'en ai fait deux versions, l'une qui utilise le modèle Whisper, at l'autre qui utilise Moonshine.
Mes conclusions :
Whisper-large produit des résultats corrects pour l'anglais et le français, mais des résultats décevants pour l'anglais avec l'accent français. Ce n'est pas un modèle temps réel : il est entraîné sur des segments de 30s, et ça demande pas mal de travail d'en tirer une latence acceptable.
Moonshine est un modèle temps réel, il permet donc d'obtenir des latences excellentes. Malheureusement, il ne supporte pas le français, ce qui est la raison pour laquelle je l'ai laissé dans une branche séparée. Je vais peut-être le rajouter en option dans la branche officielle.
As-tu essayé d'autres modèles à me suggérer ?
[^] # Re: Meilleurs modèles ?
Posté par risorseartificiali . Évalué à 5 (+6/-1).
Merci pour ce commentaire : c'est exactement le type de retour que j'espérais. Je travaille sur des modèles pour des langues que je ne parle pas, donc un peu à l'aveugle, guidé par les retours d'utilisateurs et par les chiffres des benchmarks. Or ces chiffres se sont révélés peu fiables pour la parole réelle : audio enregistré en mouvement, comme le sont les messages vocaux. Et l'accent, national ou régional, change le résultat, certains modèles s'en sortent nettement mieux que d'autres. C'est pour ça que l'application permet de retranscrire un message déjà transcrit avec un autre modèle, pour comparer facilement lequel se comporte le mieux sur un cas donné.
Mon cas d'usage reste la transcription hors ligne sur téléphone (sherpa-onnx, CPU), pas le sous-titrage en direct, donc ma comparaison ne répond qu'en partie à votre besoin. Ce que j'ai mesuré sur l'italien :
Pour galene-stt, sherpa-onnx expose une API C, donc une intégration à côté de whisper.cpp est envisageable. Si la latence est la priorité, le Nemotron streaming est la piste la plus directe pour le français ; si quelques secondes de délai sont acceptables, je testerais Parakeet TDT en segments courts, c'est pour moi le meilleur rapport qualité / vitesse sur CPU. Je n'ai aucune donnée sur l'anglais parlé avec l'accent français, je ne peux donc rien affirmer.
La collection de modèles proposée dépend des statistiques publiées en ligne, et je suis très intéressé par l'étendre à partir des retours. Un utilisateur suisse m'a par exemple signalé que les modèles d'allemand géraient mal le suisse-allemand et m'a demandé d'en soutenir un spécialisé : il est maintenant au catalogue communautaire.
Le projet étant entièrement libre, quiconque a les compétences, ou veut y lancer un agent de codage, peut expérimenter. Mais comme la plupart des utilisateurs ne sont pas techniques, l'application accepte aussi des catalogues de modèles externes : des listes pré-validées par des utilisateurs avancés, que les autres chargent en configurant simplement une URL. Elle s'étend ainsi sans changer une ligne de code, un mécanisme pensé justement pour les langues et les variantes régionales.
[^] # Re: Meilleurs modèles ?
Posté par jch . Évalué à 2 (+1/-0). Dernière modification le 05 octobre 2026 à 15:41.
Merci, je vais regarder Parakeet quand j'ai un peu de temps libre.
# FUTO
Posté par François (site web personnel) . Évalué à 2 (+1/-0).
J'utilise les deux applis FUTO Voice et Keyboard qui font ce job et sont intégrées. La reconnaissance vocale est correct
[^] # Re: FUTO
Posté par jch . Évalué à 2 (+1/-0). Dernière modification le 25 septembre 2026 à 23:05.
Elles sont basées sur le modèle Whisper.
[^] # Re: FUTO
Posté par Faya . Évalué à 2 (+0/-0).
Tu veux dire qu'on peut transférer un message vocal à Futo pour qu'il le convertisse en texte ?
[^] # Re: FUTO
Posté par risorseartificiali . Évalué à 2 (+3/-1).
Pour Anti-Vocale, oui : on partage le vocal depuis WhatsApp, Telegram ou Signal, et le texte arrive dans une notification, puis dans l'historique, avec export TXT/SRT/VTT (un bug sur l'export de fichiers est en cours de correction pour la prochaine version). Il y a aussi un bouton pour importer et transcrire un fichier audio choisi sur le téléphone, et un support partiel de Tasker pour les utilisateurs avancés. Je n'ai pas testé les applis FUTO, je ne peux pas dire si elles acceptent un vocal partagé depuis une autre application ; jch indique qu'elles sont basées sur Whisper. La différence qui compte pour ce site est la licence : Anti-Vocale est GPL et sur F-Droid, les applications FUTO sont distribuées sous une licence source-available qui restreint les projets dérivés.
Envoyer un commentaire
Suivre le flux des commentaires
Note : les commentaires appartiennent à celles et ceux qui les ont postés. Nous n’en sommes pas responsables.