
Sommaire
Cher journal,
Ça commence à faire un moment que je ne t'ai pas parlé de Bim! et j'étais effectivement sur un gros morceau ces derniers mois. Mais maintenant c'est bon, je pense avoir stabilisé mon truc et j'ai publié la version 17 récemment. Cool !
Pour rappel, Bim! est un jeu libre (code AGPL3 et assets CC-by-sa 4.0) multijoueur de type dernier survivant, et qui se joue uniquement en ligne. Il n’est disponible que pour les systèmes Android.
En plus du PlayStore, le jeu est disponible sur GitHub, F-Droid, et d’autres magasins alternatifs.
Le jeu ressemble à ceci :
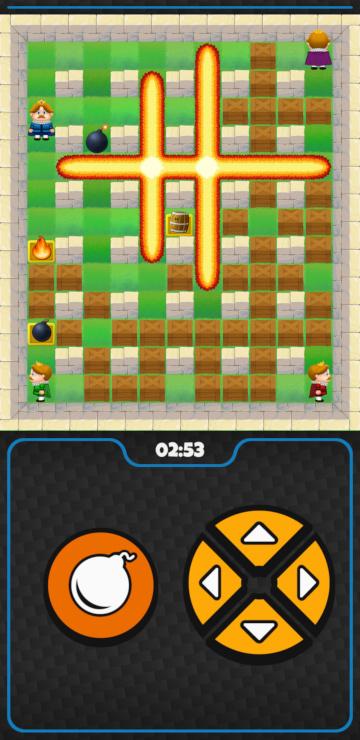
Cette nouvelle version est principalement technique. Du côté des nouveautés visibles pour l'utilisateur on aura :
- Le joueur a maintenant un pseudo. Celui-ci s'affiche sur l'écran de recherche d'adversaires.
- La durée de l'invincibilité temporaire lors de la perte du bouclier est réduite.
- Les joueurs qui perdent avant la fin d'un match nul sont considérés comme perdants (auparavant ils étaient inclus dans les ex æquo).
C'est pas énorme, alors pourquoi cela a-t-il été si long ?
Introduction de serveur business
Il y a dans la liste ci-dessous un petit truc qui a fini par me convaincre de développer un serveur « business » pour gérer l'inventaire des joueurs, la config cliente, les serveurs de jeu disponibles, etc. Il s'agit du pseudo du joueur.
Historiquement dans Bim! il n'y avait que deux gros morceaux : le client et le serveur de jeu ; et accessoirement un fichier JSON sur un serveur web, que le client allait chercher pour récupérer quelques paramètres de configuration de l'application et en particulier l'adresse du serveur de jeu. Tout l'état du joueur était sur le client (nombre de pièces, fonctionnalités acquises ou sélectionnées, etc.) Le serveur de jeu s'occupait de faire rencontrer les joueurs et leur disait en fin de partie combien de pièces ils avaient gagné.
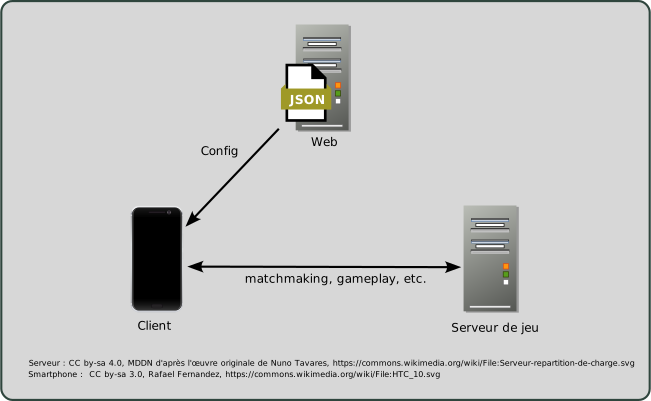
Cela me gênait un peu sur plusieurs aspects. Il y a évidemment un risque de triche à laisser le client gérer ses données mais bon, avec ma petite base d'utilisateurs je pense que ça n'a pas d'importance. Par contre, le fait d'avoir à maintenir à la main le fichier de config sur le serveur web, ça me cassait les pieds. J'ai toujours peur de me planter dans la syntaxe et je me demandais fréquemment si j'avais bien uploadé le bon fichier. Enfin, conceptuellement, ça me semblait sentir la vieille chaussette sale.
À côté de cela je voyais bien qu'il y avait des fonctionnalités envisagées qui seraient bien difficiles à faire sans avoir un serveur business. Par exemple j'aimerais faire des salles privées pour que les joueurs puissent décider de jouer ensemble plutôt que de subir le matchmaking global. Difficile de faire ça sans avoir une persistance sur un serveur. Si en plus on imagine que ces salles sont payantes et partageables, ça complexifie encore. De même si je veux faire un leaderboard, je ne vais pas le stocker sur le client.
Le pseudo du joueur aurait pu être sur le client aussi ; il l'aurait envoyé au serveur de jeu au lancement pour le faire suivre aux autres joueurs. Mais bon, ça fait un peu bricolage.
J'ai aussi envisagé de tout faire gérer par le serveur de jeu mais ça ne tient pas la route. Déjà le serveur de jeu n'a pas de persistance, quand il redémarre il a tout oublié de l'exécution précédente. Ensuite il y a fréquemment deux serveurs de jeu qui tournent simultanément : un pour la dernière version, un pour l'avant-dernière ; parfois même un pour la prochaine version. Donc il aurait fallu un stockage partagé par tous les serveurs, ce qui revient quasiment à faire un serveur business en fait.
Bref, la situation m'oblige à déployer un serveur business.
Il ne reste plus qu'à choisir la techno. Comme Bim! est en C++ c'est la première solution que j'ai envisagée. Côté positif, je connais bien ce langage donc ça sera facile de m'y mettre. Côté négatif, quand on parle de serveur business on parle de service web et de base de données, et quand on parle de service web et de base de données on pense rarement au C++. Les projets qui couvrent ce besoin sont assez niche, ça sent fort la difficulté.
D'ailleurs en parlant de difficulté il faut que je te précise que le web, que ce soit le bout devant ou le bout derrière, c'est pas trop mon domaine, et que je n'ai pas manipulé de base de données depuis un peu plus de 20 ans, pendant mes études. Cette histoire de serveur business est donc une aventure pour moi.
Le deuxième choix de techno se base sur Java, sans doute avec Spring Boot. Je connais le langage, je pense pouvoir me débrouiller avec même si j'aime bien ne pas l'utiliser, et j'ai côtoyé un excellent développeur il y a un peu plus de dix ans qui avait résolu le même problème avec ces technos. Par le biais de revues de code j'avais pu acquérir quelques concepts et je sais donc que ça répond bien à mon problème.
Troisième choix, partir sur une solution en Rust. Déjà ça fait un moment que ce langage me fait de l'œil, et en plus l'idée d'éviter les risques de failles de sécurité sur mon serveur me plaît beaucoup. C'est là-dessus que je suis parti. Par contre je n'y connais rien en Rust…
Architecture du serveur business
Comme tout développeur moderne valant son pesant de cacahuètes face à une techno dont il ignore quasiment tout, j'ai opté pour la seule solution valable. J'ai demandé à un LLM de générer l'application pour moi.
Hey ! Je n'y connais rien, c'est donc forcément mieux que ce que j'aurais fait !
Je blague bien sûr :) Je n'avais pas envie de manquer cette opportunité d'apprendre. Je me suis donc plongé dans le livre Rust - Développez des programmes robustes et sécurisés que j'avais précédemment gagné en participant sur LinuxFr.org. Un livre qui m'a semblé pas ouf quand on a plusieurs dizaines d'années de dev derrière soi mais en même temps, si je me mets dans la tête de moi ado, je pense que c'est aussi bien que les bouquins que je lisais pour apprendre le Pascal. Ça m'a permis de mettre le pied à l'étrier, copier et compiler quelques programmes sans tout comprendre, tester des trucs en modifiant des lignes pour voir ce qui se passe dans tel ou tel cas… Bref, découvrir et apprendre.
J'ai développé une petite preuve de concept dont j'avais parlé ici même et sur Reddit, en demandant des critiques pour essayer de partir avec de bonnes bases. Sur Reddit j'ai obtenu un commentaire du genre « je me suis arrêté après avoir vu quelques unwraps », pas très constructif, et une autre personne m'a envoyé une « analyse » insipide sortie d'un LLM. Je me demande à quoi sert la personne qui m’a envoyé cette analyse, j'aurais pu demander moi-même à un LLM si c'était ce que je souhaitais.
Sur LinuxFr.org j'ai reçu de super conseils de GwenLg, qui m'a accompagné dans la mise en place du projet. Soyons clairs, si quelque chose est bien fait dans le serveur business de Bim! c'est de sa faute :)
Au final ce que l'on a sur le business :
- une base PostgreSQL pour la persistance ;
- du code métier qui fait l'interface vers cette base via tokio-postgres (enfin plutôt via deadpool-postgres, qui va gérer un pool de connexions vers la base) ;
- un service web basé sur axum qui va récupérer ses infos via le module métier.
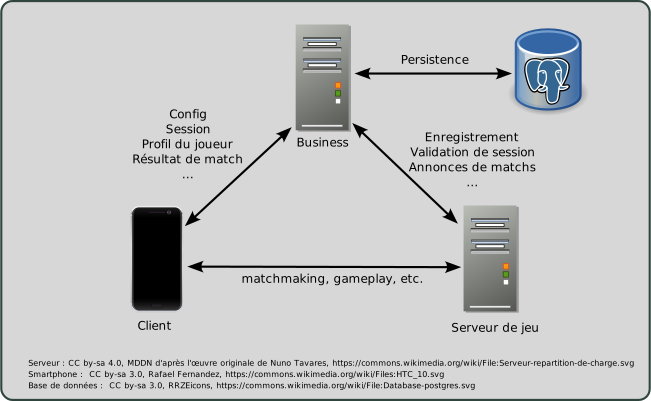
Une fois cela en place il ne restait plus qu'à décrire les tables, écrire le code métier, les services web… Je n'avais pas trop d'idée de la taille du truc en me lançant, ça s'est déroulé à mesure que je migrais les propriétés du client et du serveur de jeu vers le business. En tout cas ce qui était auparavant sur le client ne m'avait pas l'air gros. Le premier petit jalon est d'envoyer une config au client, avec la liste des serveurs de jeu, les lots de la boutique, les prix des fonctionnalités optionnelles.
Je commence simple avec le serveur de jeu. D'abord il me faut un moyen pour qu'il puisse s'annoncer lui-même auprès du business quand il est en ligne. Ah mais attends, du coup il faut que j'aie un moyen pour autoriser ces serveurs à s'annoncer, pour éviter que d'autres ne s'incrustent. Ben du coup il me faut une interface d'admin en fait… Et puis une passe de nettoyage régulière pour supprimer les serveurs qui ne donnent plus de nouvelles. Ce petit morceau n'est pas si petit.
Ensuite vient la boutique du client. Ah bah du coup il me faut une notion de boutique et une interface d'admin pour ajouter, modifier, lister, supprimer les entrées de cette boutique.
Viennent ensuite les fonctionnalités optionnelles (brouillard de guerre, barrières…). Il me faut une table pour les lister, avec leurs prix. Ainsi que le prix d'un slot supplémentaire.
Et puis il faut que je me souvienne de ce que possède le joueur, donc un inventaire, et aussi un historique des transactions.
Tiens d'ailleurs c'est quoi un « joueur » ? Bon ben il me faut un moyen d'identifier les joueurs, et donc d'avoir une notion de session, et de faire valider les sessions par le serveur de jeu aussi, pour qu'il soit en phase avec le business quand il s'agit d'attribuer les gains à un joueur.
Ah bah il y a ça aussi. Le serveur de jeu doit informer le business quand une partie commence, quand elle termine, et quel est le résultat, afin que ce dernier puisse mettre à jour les stats du joueur et lui donner ses gains.
Petite parenthèse, si tu te demandes comment le business identifie un joueur, c'est un UUID que l'app cliente génère au premier lancement. C'est plus un identifiant d'installation qu'un identifiant de joueur. Cette UUID n'existe que sur l'appareil du joueur et dans une table sur le serveur.
Bon, mis bout à bout, je me retrouve avec 25 tables en tout et une trentaine d'URLs.
Et il eut un nom
Sur la fin de tout ce chantier j'ai implémenté la possibilité de donner un pseudo au joueur ; l'élément qui avait fait pencher la balance vers le développement du serveur business. Mais quel nid à problèmes que de laisser le joueur choisir son pseudo !
Alors évidemment il y a le risque que l'utilisateur entre n'importe quoi. On est sur Internet, je te connais, tu vas mettre des trucs affreux en te croyant futé. J'ai donc mis un moyen pour l'admin de facilement remplacer le pseudo de quelqu'un. J'ai aussi mis un délai entre deux changements de pseudo pour éviter que les joueurs mettent un truc insultant (par exemple) juste le temps d'une partie et que je ne puisse pas voir le problème.
Ensuite il y a la question de la taille du pseudo. Je ne peux pas laisser une longueur libre, sinon ça devient un espace de stockage (et puis ça va tout casser), donc j'ai mis une longueur max arbitraire. J'ai mis une longueur min aussi mais celle-ci me semble moins pertinente. Cela m'a évidemment amené au chouette sujet du nombre de caractères dans une chaîne Unicode, que j'ai lâchement délégué à une lib parce que c'est bon ça va bien deux minutes.
Et puis il y a le sujet de l'affichage du pseudo.
Ça m'est venu quand j'ai entré un premier pseudo contenant un émoji. Avec le moteur que j'utilise sur le client les labels affichant les textes sont paramétrés avec une seule police, qui plus est embarquée dans le package de l'app (i.e. ils n'utilisent pas les polices système). Que se passe-t-il si la police ne contient pas le glyphe ? Rien. Ça n'affiche rien. Rhalala que vais-je faire si l'utilisateur commence à utiliser des trucs que je n'ai pas prévus ? Des émojis, des symboles asiatiques ou arabes… Et puis je ne vais quand même pas embarquer toutes les polices possibles, ce serait idiot.
Je dis que le moteur n'utilise pas les polices systèmes mais ce n'est pas tout à fait vrai. Il y a un mode de label qui utilise bien le système, mais alors je n'ai plus les contours sous Linux, et je ne bénéficie plus de la fonction de réduction de police automatique pour éviter les débordements. Pas ouf.
Bon ben c'est l'impasse. Soit j'abandonne, soit je me retrousse les manches. C'est le début du développement surprise dans la dernière ligne droite : je patche le moteur pour qu'il puisse gérer plusieurs polices par label. Un boulot considérable qui touche à un élément clé et qui impacte donc tout le monde. Des labels il y en a de toutes les sortes, avec des polices bitmap à l'ancienne, avec du FreeType, avec des tonnes d'effets à prendre en compte (contour, ombre, souligné, glow…) et des shaders à gérer. Je découvre dans la foulée que la police émoji que j'utilise (Noto) expose des glyphes bitmap couleur, or les labels du moteur ne prennent en compte que les glyphes vectoriels monochrome. Tout faux. J'implémente donc la gestion des polices TTF bitmap couleur (tout passe par FreeType). Enfin j'ajoute aussi la possibilité d'aller piocher dans d'autres polices et dans les polices système quand un glyphe manque dans la police principale d'un label. C'est pas hyper évident puisqu'il faut déjà trouver les fichiers qui ont le glyphe, mais aussi dans un style proche de l'initial (e.g. gras si le principal est gras). Il y a des outils pour trouver des polices proches selon diverses caractéristiques ; j'ai utilisé Fontconfig sous Linux. Sous Android il y a une API à partir de la version 29 mais comme c'est un peu trop haut pour ce que je vise (23) et que ça ne couvre pas tout mon besoin, j'ai implémenté un truc ad-hoc.
J'ai appris quelques trucs en chemin. Déjà savais-tu que les polices TTF pouvaient avoir des glyphes en SVG ? Il y a une version de la police Noto Emoji qui utilise ça. Je n'ai pas implémenté le support parce que c'était déjà bien assez compliqué comme ça. En fait il y a tellement de trucs dans TTF que je me demande si ça ne serait pas Turing-complet.
Autre découverte, l'existence de GNU Unifont. C'est une police bitmap monochrome avec des glyphes en 8×16 ou 16×16 pixels qui couvrent tout Unicode. C'est tout sobre, tout petit, tout mignon.
Après tout ce travail sur le moteur, j'ai remonté mon patch au projet amont. J'ai un peu hésité, car la dernière fois que j'ai voulu y contribuer j'ai eu une très mauvaise expérience. De l'autre côté je pense que contribuer en amont est La Bonne Chose À Faire™, et puis je n'ai pas envie de maintenir un gros patch comme ça sur mon fork. J'ai donc créé une PR et, quel plaisir, elle a été bien reçue. Elle n'est pas mergée, mais elle est bienvenue.
Quelques mots sur les tests
Côté serveur il n'y a pas tellement d'algorithmique ni même de structures de données hormis quelques commodités. Je n'ai pas grand-chose à tester à part vérifier que chaque URL fait bien ce qu'on lui demande. Du coup en guise de tests j'ai juste des tonnes de commandes curl. Ce qui est cool c'est que ce sont des tests comme si les requêtes venaient du client ; c'est rassurant. En général j'ai un endpoint qui me permet de vérifier le résultat, autrement je fais aussi quelques requêtes en base. Ça m'a bien servi pendant le dev. Comme d'hab', ça me casse les pieds d'écrire les tests, mais je suis bien content de les avoir écrits quand je fais de grosses modifs dans le code principal.
Le plus pénible dans tout ça est qu'il faut lancer un serveur Bim! et un serveur PostgreSQL. Et c'est encore pire côté client. Avant j'avais besoin de lancer un serveur de jeu pour tester l'app, maintenant il faut en plus que je lance le business et que j'attende que le serveur de jeu s'y enregistre. Un peu galère, heureusement j'ai pu automatiser tout ça.
Côté client c'est assez compliqué de tester toutes les requêtes vers le serveur, par conséquent j'ai des mock-ups et je teste surtout la sérialisation des données envoyées et hypothétiquement reçues. J'ai aussi des tests d'UI qui passent par tous les écrans, avec ça je pense couvrir une bonne partie de l'expérience utilisateur. J'ai juste zappé les tests automatiques sur l'envoi de l'inventaire historique parce que flemme. Et devine ce qui a crashé lorsque j'ai entamé les tests manuels ? Et ouais… En plus ça m'a bien pris la tête de trouver la cause. J'aurais dû écrire plus de tests.
Quelques mots sur Rust
J'en profite pour te faire un petit retour de nouveau venu dans le monde de Rust. Il y a des trucs cool, des trucs moins cool, mais globalement je suppose que ce qui me déplaît est surtout lié au fait que je viens de débarquer et que je ne connais rien à l'outil.
Le fameux borrow-checker est vraiment super. C'est bien galère de le satisfaire, mais on voit vite que ça vaut le coup.
La gestion des erreurs me semble inutilement précise. La plupart des erreurs ne sont pas gérées et sont juste remontées à l'appelant. Ça fait plein de gestion et de transformations d'erreurs tout ça pour qu'à la fin on fasse juste un test d'existence équivalent à « y a-t-il une erreur ? ». Pas très utile. Je pense que des exceptions auraient très bien fait le job, mais il n'y en a pas en Rust. C'est dommage parce qu'après des décennies à entendre l'industrie répéter avec insistance que les exceptions c'est nul pour les perfs quelqu'un s'est décidé à vérifier et a découvert qu'en fait c'était super. En plus des perfs ça allégerait aussi les interfaces. (Oui je sais que les exceptions c'est nul aussi pour la lisibilité et que ça cache les problèmes :))
Pas lié à Rust directement mais les outils que j'ai choisis imposent la programmation asynchrone avec tokio. Ça fait que j'ai des awaits partout, c'est un peu lourd. J'aurais préféré une solution synchrone avec un parallélisme plus haut niveau. Si t'ajoutes à ça les points d'interrogation pour remonter les erreurs, ça.await? devient.await? risible.await?
La forme if let Some(x) = y est vraiment agréable et je me suis surpris à retravailler des fonctions pour tomber là-dessus plutôt que d'avoir des unwrap().
Beaucoup trop d'appels à l'aide autour de Rust reçoivent des réponses rabaissantes du type « ce n'est pas ce que tu veux faire » ou le classique « les ordis d'aujourd'hui sont assez puissants ». J'ai l'impression d'être revenu des années en arrière. Quand quelqu'un te demande comment faire quelque chose, dis-lui d'abord comment faire, et seulement ensuite tu peux lui expliquer pourquoi tu penses que c'est une mauvaise façon d'aborder le problème.
Les temps de compilation sont plutôt longs et le fait de ne pas pouvoir compiler des fichiers individuellement est vite handicapant. De plus Rust n'a pas grand-chose à envier à C++ en termes de verbosité des messages d'erreur et pour peu qu'il y ait un Trait mal placé c'est vite l'enfer à démêler malgré les suggestions du compilateur.
Je suis assez mitigé sur Cargo qui me télécharge tout Internet pour tirer les dépendances, ainsi que sur cette manie de faire des libs minuscules pour chaque chose. D'un autre côté ça a l'air plutôt bien fait et plus robuste que ce qu'on peut voir côté NodeJS, mais ne risquons-nous pas nous aussi de chopper des cochonneries à tirer des arbres de dépendances comme ça dans tous les sens ?
Voilà c'est ce qui me vient en tant que nouveau. Peut-être que la prochaine fois, avec un peu plus d'expérience, j'aurais changé d'avis et je te dirai l'inverse :)
Le code
Ah oui au fait, le code est ici. C'est de l'AGPL3. J'ai beaucoup hésité à tout mettre dans le dépôt de Bim! car ça serait plus simple pour les tests, mais en même temps le fait d'avoir un dépôt à part m'encourage à penser le serveur comme un véritable projet indépendant. Je pense que c'est mieux pour le logiciel mais je ne m'interdis pas de fusionner l'ensemble à l'avenir.
Quelques stats
Comme à l'accoutumée on va faire un petit point statistiques de jeu. La précédente version introduisait les bots pour que les joueurs puissent jouer même si le serveur de jeu ne leur trouvait pas d'adversaire. Cela a-t-il changé quelque chose sur l'activité ?
Si on regarde le nombre de parties par heure, ça me semble assez clair qu'il y a une augmentation par rapport à ce qui était présenté dans le précédent journal avec des pics réguliers au-delà de 30.
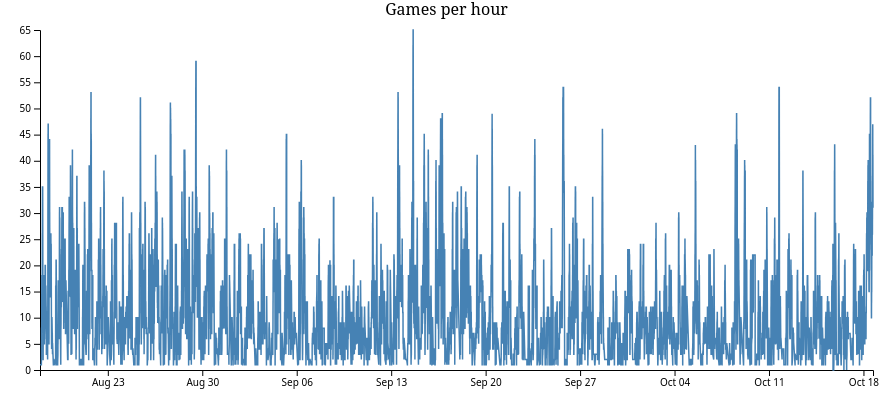
Côté sessions il y en a moins de 20 par heure, à part début septembre où il y a eu un pic énorme pour une raison que j'ignore, sans lancer de parties apparemment. Ça a l'air de venir des US, mais je n'ai pas cherché plus que ça.
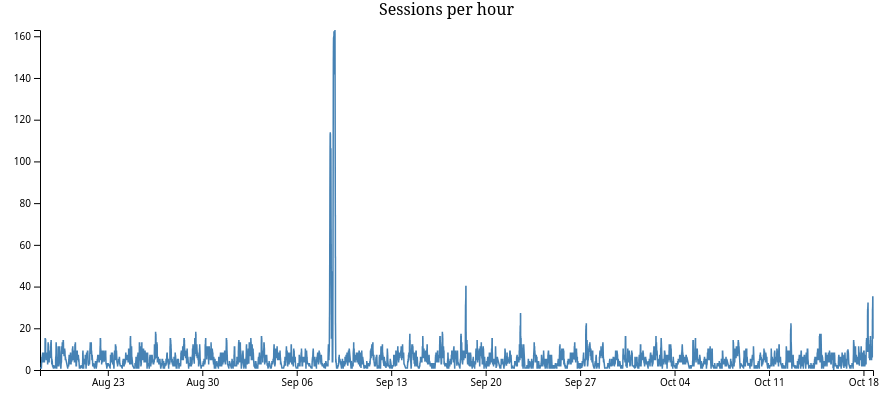
En termes de répartition du nombre de joueurs par partie, en agrégeant les parties depuis le déploiement de la version 16, le 20 avril, jusqu'à aujourd'hui (environ 6 mois) on en est à peu près à :
| Nombre de joueurs | Nombre de parties |
|---|---|
| 1 | 51 508 |
| 2 | 4049 |
| 3 | 330 |
| 4 | 34 |
Des scores à la fois plaisants et un peu décevants. Plaisants parce que ça fait pas mal de parties mais décevants parce que le nombre de parties entre humains est proportionnellement plus bas que ce qu'on avait dans le journal précédent. À l'époque, sur trois mois, c'était 4150 parties à deux, 916 à trois, et 293 à quatre. Je ne sais pas trop quoi en penser. J'imagine que c'est un bon score quand même et que mécaniquement s'il y a plus de joueurs ils vont bien finir par tomber les uns sur les autres.
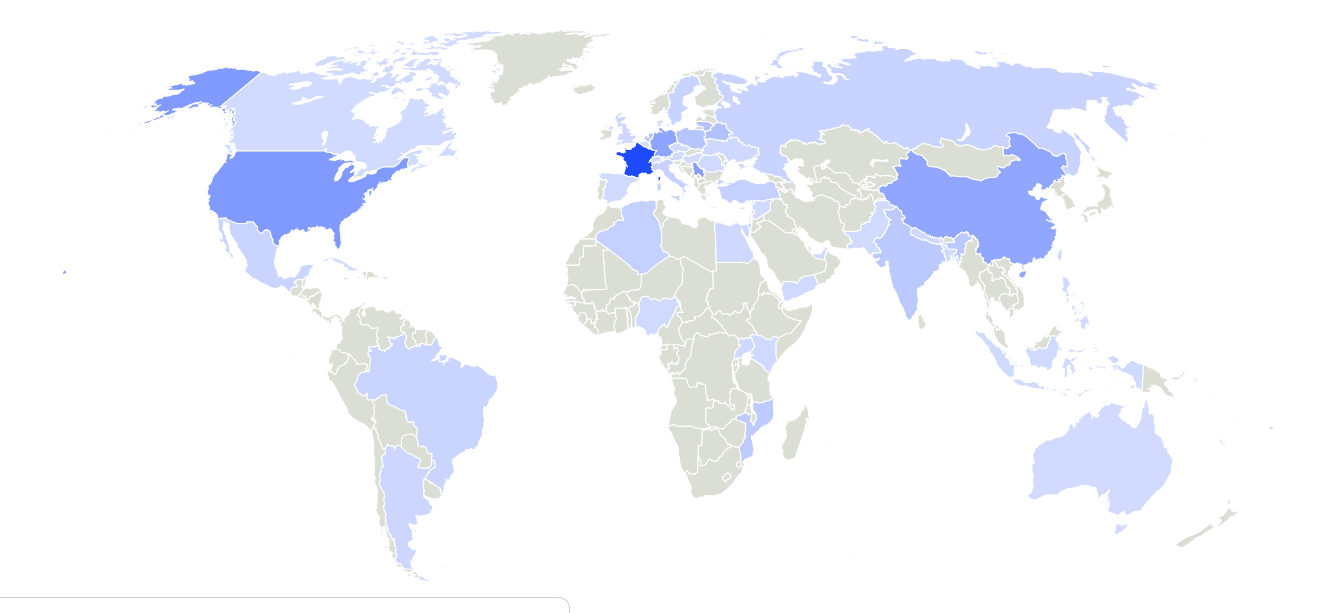
Enfin, on finit avec la répartition par pays :
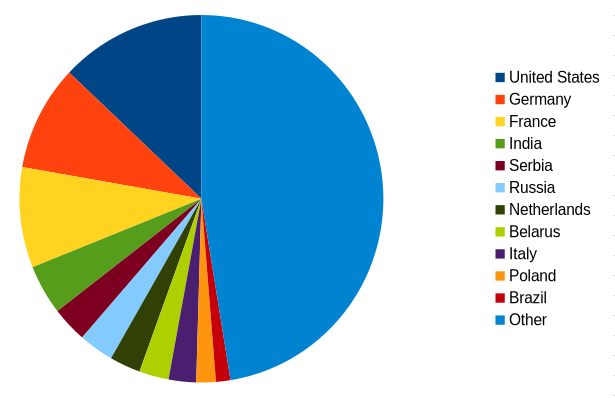
Et la même donnée vue par PostHog, pas tout à fait identique, mais proche :
Ça sera tout pour cet article vachement technique. On se retrouvera pour la prochaine version avec, j'espère, plus de nouveautés visibles pour les joueurs :)
# Parlons des exceptions
Posté par pulkomandy (site web personnel, Mastodon) . Évalué à 9 (+6/-0). Dernière modification le 02 novembre 2026 à 10:07.
C'est une vision assez liée à l'implémentation des exceptions en C++, qui a été greffée sur le modèle d'exécution du C pas prévu pour ça au départ.
Si on prend Java par exemple, la gestion des exceptions est très différente. Dans le bytecode Java de chaque méthode, il n'y a rien pour traiter les exceptions. Cela se fait via une table séparée qui met en correspondance un range de bytecode, et le bout de code à appeler dans ce cas (le code du catch() correspondant).
Tant qu'une exception n'est pas levée, le coût est de 0, le bytecode n'a pas besoin d'exécuter quoi que ce soit pour vérifier s'il y a eu une exception ou pour préparer un try/catch. Lorsqu'il y a une exception, on remonte dans la stacktrace et on vérifie chaque méthode pour voir si le pointeur de code est dans un range de bytecode qui a un handler d'exceptions (c'est pas cher: deux comparaisons d'entiers), puis on vérifie si le handler correspond au type d'exception levé (sinon on passe à la stackframe suivante).
La destruction des stackframes et des objets est faite par le garbage collector, ce qui n'est pas différent de la sortie via un return(). Par contre, l'exécution de code dans le destructeur des objets n'est pas aussi déterministe que en C++ et c'est assez peu utilisé. Donc adieu la RAII, qui pourtant aurait été très pratique dans ce modèle. Obligé de nettoyer les ressources dans un block catch ou finally.
L'implémentation historique des exceptions en C++ c'était pas du tout ça: c'était basé sur setjmp() lors du try et longjmp() lors du throw, avec du code généré pour l'appel des destructeurs à chaque étage de la stacktrace (donc dans chaque fonction, y compris celles qui n'ont pas de try/catch). D'où la mauvaise réputation des exceptions en C++. Ça s'est amélioré depuis mais ça n'atteint probablement pas tout à fait les performances de Java en la matière (mais il y a le nettoyage automatique et déterministe des ressources via l'exécution des destructeurs, donc le compromis est intéressant pour une autre raison).
Pour la lisibilité enfin: en C++, rien n'est prévu pour qu'une fonction doive déclarer quelles exceptions elle est susceptible de lancer. Et en plus on peut lancer vraiment n'importe quoi. "throw 42;" est accepté par le compilateur. Avec une déclaration explicite et un truc qui force que toutes les exceptions dérivent d'une classe commune (std::exception par exemple), ce serait peut-être mieux. Bien que on se retrouverait sûrement avec tout le monde qui déclare "cette fonction peut lancer n'importe quelle exception". D'où l'utilisation de l'approche opposée en C++ moderne: déclaration de nothrow quand on est sûr d'avoir intercepté toutes les exceptions possibles.
[^] # Re: Parlons des exceptions
Posté par Tarnyko (site web personnel) . Évalué à 5 (+3/-0).
Effectivement, il faut faire gaffe : les exceptions en C++, c'est super-lent (ne jamais utiliser un "catch" comme l'équivalent d'une branche de "if").
Comme d'hab', c'est une question d'écosystème plus que de pattern.
[^] # Re: Parlons des exceptions
Posté par Claude SIMON (site web personnel) . Évalué à 6 (+4/-0).
Pour autant que je me souvienne, le coût de la gestion des exceptions est nul dans C++ tant qu'une exception n'est pas levée.
Une rapide recherche me donne ça : https://llvm.org/docs/ExceptionHandling.html#itanium-abi-zero-cost-exception-handling
Zelbinium: pour la génération qui crée, pas celle qui scrolle…
[^] # Re: Parlons des exceptions
Posté par pulkomandy (site web personnel, Mastodon) . Évalué à 5 (+2/-0).
Oui pour les plateformes utilisant les tables dwarf. Non %our celles (s'il en reste) cui utilisent setjmp/longjmp (dans ce cas, on paie un coût à l'entrée dans un bloc try/catch, mais par contre le traitement d'une exception levée est plus rapide). Et il y a les exceptions de Windows, qui sont un autre truc dont le traitement ressemble un peu aux signaux unix (sous Windows, il faudrait en principe gérer séparément les deux: exceptions C++ et exceptions Windows).
C'est l'implémentation historique setjmp/longjmp qui a fait la mauvaise réputation des exceptions bien que ça ne soit plus trop d'actualité.
[^] # Re: Parlons des exceptions
Posté par Tarnyko (site web personnel) . Évalué à 3 (+1/-0).
Toutafé.
Le problème était que des gens s'en servaient (et s'en servent parfois encore) comme de la branche courante d'un "if … else".
[^] # Re: Parlons des exceptions
Posté par devnewton 🍺 (site web personnel) . Évalué à 7 (+4/-0).
C'est quand même bien pratique !
Ce post est offensant ? Prévenez moi sur https://linuxfr.org/board
[^] # Re: Parlons des exceptions
Posté par Tarnyko (site web personnel) . Évalué à 2 (+0/-0).
Omaïegaude :) !
[^] # Re: Parlons des exceptions
Posté par Julien Jorge (site web personnel) . Évalué à 6 (+4/-0).
Merci pour l'historique :)
J'ajouterais que, si je me souviens bien, en Java on doit effectivement annoncer la couleur dans la signature mais en pratique c'est tellement casse-pied qu'on finit par dériver de
RuntimeException, qui n'a pas besoin d'être déclaré.En C++ effectivement on lance tout et n'importe quoi. Dès fois on se dit qu'on va mettre
noexceptpour indiquer qu'il n'y a pas d'exceptions, mais en fait ça fait surtout que le compilateur va générer du code pour appelerstd::terminateau cas où il y aurait quand même une exception dans les fonctions appelées par celle marquéenoexcept. Pas ouf.Mais en réalité si j'ai bien compris Khalil Estell (ça fait longtemps, j'ai peut-être oublié), le code généré pour gérer les exceptions, appeler les destructeurs, etc. N'a pas vraiment d'impact sur les perfs du moment qu'il n'est pas exécuté. C'est un discours que j'ai déjà entendu en fait. D'ailleurs Khalil mesure même la différence de perf entre du code qui utilises des exceptions et du code qui suit les règles de l'art, avec des tonnes de
ifs pour vérifier les erreurs remontées avec unstd::expected, et les perfs sont du côté des exceptions, parce que les branches ça coûte cher.Alors effectivement si on utilise les exceptions pour contrôler le flot d'exécution, c'est probablement nul, mais si c'est pour des situations… exceptionnelles, ça fait le job je pense. Dans mon cas quasiment tous les problèmes finiront en erreur 500 avec une trace de log donc bon, c'est pas la peine non plus de faire toute une danse autour des erreurs :) Après je n'ai pas creusé pour le Rust mais peut-être que l'absence d'exception est aussi une contrainte pour l'analyse du flot d'exécution à la compilation ?
[^] # Re: Parlons des exceptions
Posté par Tarnyko (site web personnel) . Évalué à 4 (+2/-0).
Je confirme que dans le cas du C++, tout baigne tant que le
catch { ... }n'est pas un cas courant mais très exceptionnel.Pour Rust, je crois qu'ils ont trouvé que les
Resultn'étaient pas pire que des exceptions logicielles avec contexte (cas d'une stack profonde où on se donne la liberté d'intercepter à X niveaux jusqu'àmain()) et donc que ça revenait au même ; mais c'est juste un résumé de ce que j'ai lu ailleurs. Je passe la main à quiconque de mieux informé ![^] # Re: Parlons des exceptions
Posté par Dr BG . Évalué à 9 (+7/-0). Dernière modification le 02 novembre 2026 à 21:59.
(je pense que tu dois le savoir, mais je profite du commentaire)
Alors ça, c'est de la mauvaise pratique, et parfois de la méconnaissance. En Java, l'idée et qu'il y a deux types d'exceptions : les runtime exceptions et les checked exceptions. Les premières sont pour les erreurs de programmation mal gérées : t'as pas le bon argument, t'as un null alors qu'il fallait pas, t'as dépassé les bornes du tableau, etc. Dans ce cas, ton programme doit péter, t'es pas censé rattraper le coup. Les secondes sont les évènements plus ou moins imprévus qu'il faut prendre en compte, typiquement lors des entrées/sorties : ton fichier n'est plus accessible, ton réseau est coupé, ton fichier est corrompu, etc.
Les premières ne font pas partie de la signature de la fonction et n'ont pas as être rattrapées (même si on peut, mais c'est douteux), les secondes se retrouvent déclarées dans la signature et doivent être explicitement gérées (et les transformer en RuntimeException par flemme, c'est pas bien).
À noter qu'en Kotlin, on ne s'embarrasse pas avec ça, on n'est plus obligé de gérer les check exceptions.
[^] # Re: Parlons des exceptions
Posté par pulkomandy (site web personnel, Mastodon) . Évalué à 3 (+0/-0). Dernière modification le 04 novembre 2026 à 15:40.
Ah je me rend compte que j'ai oublié un truc:
En C++ on a le minimum syndical, en particulier dans les exceptions, on a pas de backtrace par défaut pour savoir où le problème s'est déclenché.
Ça les rend plus rapides, mais par contre cela peut rendre les choses un peu difficiles à investiguer. Et c'est dommage parce que de toutes façons, le traitement de l'exception va devoir parcourir la stack pour déclencher les destructeurs à chaque étage. Donc si on rajoute un bout de code qui ajoute des stacktraces dans les exceptions, on se retrouve à faire le travail 2 fois.
Peut-être que quelqu'un parmi les participants à C++ va s'en rendre compte et nous proposer une meilleure solution un jour.
[^] # Re: Parlons des exceptions
Posté par BAud (site web personnel) . Évalué à 2 (+0/-0).
avec https://linuxfr.org/users/colargol/liens/le-c-26-refuse-a-l-iso-une-premiere-dans-l-histoire-du-langage ça va être l'occasion :D
[^] # Re: Parlons des exceptions
Posté par kantien . Évalué à 7 (+5/-0). Dernière modification le 04 novembre 2026 à 17:31.
Non, comme pour de nombreux choix de design, le langage Rust a emprunté des idiomes standards de la programmation fonctionnelle statiquement typée (et cela ne nécessite aucune primitive supplémentaires, contrairement aux exceptions).
Je vais essayer d'expliquer un peu l'idée qu'il y a derrière.
Comme de nombreux langages, Rust a un système de type statique. Le mot type, tel qu'utilisé en programmation (et en logique mathématique d'où il est originaire), n'a qu'une seule signification pour moi : c'est un synonyme du mot concept, et plus précisément, de celui de concept mathématique (on construit les objets qui relèvent d'un concept donné). Ainsi, quand tu écris
b : bool, cela se traduit en français par b est un boolèen. On pourrait utiliser la même notation pour écrire que Socrate est un homme, en écrivantSocrate : Homme.Maintenant, pour pouvoir utiliser des concepts (ou types), il faut tout d'abord les définir. Mais, pour écrire une définition, il faut utiliser une proposition, comme celle-ci : un homme est un animal bipède sans plumes. Cette définition est issue de Platon, ce qui permit à Diogène le cynique de le railler en se promenant dans les rues d'Athènes, tenant dans sa main un poulet déplumé, tout en criant : Voici un homme ! Voici un homme !
Plaisanterie, mise à part, Rust (comme Haskell ou OCaml, langage dans lequel étaient écrits les premiers compilateurs Rust) utilise trois formes de propositions pour définir des types : la disjonction exclusive (le ou logique), la conjonction (le et logique) et l'implication (le si A alors B), ce que les logiciens appellent la logique propositionnelle du second ordre (le second ordre signifie ici que l'on a des types génériques, au premier ordre il n'y en a pas, comme dans le langage C).
Venant du C++, tu connais déjà les définitions conjonctives et implicatives : ce sont celles que l'on trouve dans tous les langages sous le noms de records, enregistrement ou structures (pour la conjonction) et de fonctions (pour l'implication). Rust (comme les langages fonctionnelles depuis les années 80) ajoute les définitions disjonctives sous le terme de types enum : ce qu'est le type
Resultutilisé pour la gestion des erreurs. Un valeur de typeResult <T,E>est ou bien une valeur de typeTou bien une valeur de typeE(la disjonction exclusive me semble assez visible dans la définition que je viens de donner).Voilà déjà le premier point : il n'y a rien de spécial à ajouter au langage, aucune nouvelle primitive de gestion d'exception à ajouter, il suffit de se servir d'une fonctionnalité déjà existante du langage, à savoir les types enum (ou types somme).
Petit aparté algébrique. On appelle communément les types que l'on rencontre dans ces langages comme des types algébriques. Cela vient de la remarque suivante. Quand tu vas au restaurant, tu peux avoir le choix dans le menu entre plat et entrée ou plat et dessert. Ici, la disjonction est exclusive, et le choix peut se factoriser en plat et (entrée ou dessert), ou encore sous la forme algébrique suivante :
Ainsi, les types enum sont appelés types somme, les types struct sont appelés types produits, quant au types des fonctions ce sont les exponentiels (si le type A a deux élément et le type B trois éléments, alors le type des fonctions de A dans B (
A -> B) a 3² éléments).J'ai alors tendance à écrire le type
Result <T,E>comme étantT + E. Les programmeurs sont plus habitués aux types produits, que l'on nomme aussi produits cartésiens, mais les types sommes sont aussi d'une grande utilité (comme le montre la gestion des erreurs) et malheureusement absent de la plupart des langages.Il y a un autre type somme fort utile pour la gestion des erreurs :
1 + T, que Rust appelleOption <T>. Ce type est en réalité celui des pointeurs surT: ou bien on pointe sur une valeur de type T, ou bien on n'a rien et un pointeur surnull(d'où le1dans ma somme, pour désigner le type qui n'a qu'une seule valeur, à savoirnull). L'avantage d'implémenter cela dans le mécanisme général des types sommes est que le compilateur oblige (par un test d'exhaustivité sur le patter matching des types sommes) à traiter le cas du pointeurnull: on n'a plus de pointeurnullqui se promène, et cela gratuitement, sans ajout particulier au langage.Un autre type somme remarquable est celui des listes chaînées. Celui-ci est amusant car sa définition est récursive :
List <T> = 1 + T * List <T>. Une liste chaînée sur un typeTdonné est soit la liste vide (le1), soit la donnée conjointe d'une valeur de typeT(appelée tête) et d'une autre liste surT(appelée queue). On retrouve bien la forme disjonctive de la définition (soit… soit…). Maintenant, si on remplace dans le membre de droite de la définition récursiveList <T>par sa propre définition, on obtientList <T> = 1 + T * (1 + List <T>) = 1 + T + T * List <T>. Et si on recommence encore la même substitution, on aboutit à cela :à savoir une somme infinie qui affirme qu'une liste est soit la liste vide, soit une liste à un seul élément, soit une liste à deux éléments, soit une liste à trois éléments, etc.
On pourrait recommencer avec les arbres binaires, les arbres en général : nombre de structures de données ont des définitions naturelles comme structure récursives de types sommes. Les implémenter ainsi permet aux types checker de vérifier de manière exhaustive que tous les cas de la disjonctions sont bien traités dans le code.
Revenons, maintenant, à la gestion des erreurs. Comme je le disais, au début de mon commentaire, Rust utilise les idiomes de la programmation fonctionnelle pour la programmation système. En programmation fonctionnelle, on ne voit pas un programme comme une série d'instructions que l'on donne à la machine (ça c'est le point de vue du paradigme impératif), mais comme le calcul d'une valeur en composant des fonctions : un programme est une suite de transformation que l'on compose entre elles.
Je vais donner un exemple en OCaml (dont je maîtrise mieux la syntaxe que celle de Rust) pour illustrer l'idée. Je définis deux fonctions
double : int -> intetsquare : int -> intqui calcule le double et le carré d'unint:Maintenant je peux les composer pour calculer soit le carré du double, soit le double du carré :
Et si, j'ai une liste de int, je peux les appliquer en masse à toute la liste :
On va s'arrêter un peu sur le type
List. Ma fonctiondoublea pour typeint -> int, c'est une fonction des int dans les int. Mais le type paramétrique est, lui aussi, une fonction, mais cette fois des types dans les types :List : Type -> Type. Je peux lui donné en entrée un type (disonsu8) et il me retourne un nouveau type en sortie (ici le typeList <u8>). Ce que j'ai fais au-dessus, avec mon code, peut s'exprimer de manière générale dans le diagramme ci-dessous :Où ici
Fest un type paramétrique quelconque (Listdans mon code, mais cela peut tout aussi bien êtreResult). Ce qu'expriment les flèches horizontales est le principe de la compositions de fonctions : si je peux tranformer unAenBviaf, puis unBenCviag, alors en les composant je peux transformer unAenC.Les flèches verticales, quant à elles, expriment que étant donné une valeur de type
A(idem pour B et C) je peux construire une valeur de typeF(A)(pour les listes cela revient à dire que j'ai une liste à un seul élément, et pourResultque si tu as une valeur de typeT, tu disposes aussi a fortiori d'une valeur de typeResult <T, E>).Maintenant, le diagramme exprime que deux chemins distincts qui mènent au même point calcul la même chose :
Revenons, pour finir, au principe de la gestion des erreurs, qui était le sujet initial du commentaire, c'est-à-dire avec le type paramétrique
F = Result. Quand on a des calculs qui peuvent lever des erreurs, on n'a plus seulement des fonctionsf : A -> Betg : B -> C(ici ce sont des calculs sans erreurs possibles), mais des fonctions dont le type sontf : A -> F(B)etg : B -> F(C), autrement dit soitfcalcule unBà partir d'unA, soit elle renvoie une erreur. Ici, dans mon diagramme, ce sont les diagonales que l'on veut composer entre elles : on ne peut pas brancher la sortie defsurgcargattend unBquefn'est pas garantie de lui fournir. Les programmeurs fonctionnels ont alors inventé un nouvel opérateur de composition pour cela qu'ils appellent lebind:comme son type le montre, son rôle est de brancher la sortie de
fsur l'entrée deg. Dans le cas du typeResult, son implémentation est triviale : elle consiste à propager les erreurs vers l'appelant (c'est l'équivalent de la propagation des exceptions). En OCaml cela donne :Après, Rust (comme Haskell ou OCaml) fournit du sucre syntaxique pour faire ces branchements (comme il le fait pour le type
Option), mais l'idée fondamentale est celle que j'ai décrite.Pour finir, un exemple de code en OCaml qui possède à la fois des exceptions classiques (
try... with) et le typeResult. Je vais prendre deux fonctionsiosetios_exn(qui convertissent unstringenint,iospourint_of_string) soit en renvoyant uneResultpour la première, soit en levant une exception pour la seconde. Je vais alors m'en servir pour ajouter deux chaînes de caractères, avec gestion des erreurs :L'avantage de passer par le type
Resultest le même que celui des check exception en Java : les fonctions qui peuvent générer une erreur le signale par leur type, et l'on est obligé de les gérer, sauf si l'on fait ununwrapcomme un goret ! En réalité, la fonctionunwraptraite bien les erreurs, mais en émettant unpanic, ce que l'on peut qualifier de gestion par dessus la jambe des erreurs. Le code deunwrapest :Pour un serveur, c'est là une pratique à éviter si tu ne veux pas te retrouver comme Cloudflare.
Sapere aude ! Aie le courage de te servir de ton propre entendement. Voilà la devise des Lumières.
[^] # Re: Parlons des exceptions
Posté par kantien . Évalué à 3 (+1/-0).
Après relecture, je me rends compte qu'il y a une erreur de calcul dans le développement du type paramétrique
List <T>. Le résultat est correct, mais il y a une erreur dans mon premier développement :Pour ceux qui ont fait du calcul différentiel et étudié les séries de Taylor, on peut prendre la dérivée du polynôme :
ce qui donne une nouvelle structure de données, connue sous le nom de zipper. Cela se généralise à toutes sortes d'arbre (voir l'article en lien), et cette structure pointe sur un noeud et permet de se déplacer localement dans la structure d'origine (d'où son lien avec la dérivation). La fermeture éclaire n'est autre que la dérivée de la liste chaînée. ;-)
En ce qui concerne les erreurs, je voudrais faire cet ajout. Dans le code avec le type
Result:à la première erreur, on saute sur la branche
Error _sans passer par les lignes suivantes, comme pour les exceptions. Ce pattern abstrait un motif que l'on retrouve en Golang qui retourne aussi des valeurs, mais sous forme de paires, en cas d'erreur :Mais on se retrouve alors à avoir le code de gestion d'erreur mélangé au reste, là où le
bindpermet de séparer le code sans erreur de la gestion des erreurs, comme avec les exceptions.De plus, Golang renvoie un type produit plus grand que le type somme :
Sapere aude ! Aie le courage de te servir de ton propre entendement. Voilà la devise des Lumières.
# J'ai ri
Posté par serge_sans_paille (site web personnel) . Évalué à 9 (+8/-1).
Merci pour ce moment \o
J'adore lire tes journaux.
[^] # Re: J'ai ri
Posté par Julien Jorge (site web personnel) . Évalué à 6 (+4/-0).
Merci ! Je ne réagis pas toujours aux tiens mais c'est réciproque ;)
# Les questions qui fâchent
Posté par Luc-Skywalker . Évalué à 3 (+1/-0).
Quel est le petit nom du serveur de jeu ? gandalf, mistigri, xor27, … ?
Et de celui du buisness ? manu, jean-luc, ed-is-dead … ?
moi, ce qui m'aurait intéressé sur le coup, c'est: quelles machines, pour quelle charge effective en service et pour combien de roro en € au final ?
merci pour ce journal bien sympa ;)
"Si tous les cons volaient, il ferait nuit" F. Dard
[^] # Re: Les questions qui fâchent
Posté par gUI (Mastodon) . Évalué à 4 (+1/-0).
Comme dit un copain "Le plus dur en informatique c'est de trouver le nom des variables et le nom des machines. Le reste tu peux toujours l'apprendre".
En théorie, la théorie et la pratique c'est pareil. En pratique c'est pas vrai.
[^] # Re: Les questions qui fâchent
Posté par Julien Jorge (site web personnel) . Évalué à 8 (+6/-0). Dernière modification le 03 novembre 2026 à 23:28.
J'ai fait simple. Le serveur de jeu s'appelle « world-official » en base, et tous les services sont sur une machine nommée vps-un_hash… Par contre j'ai plein de noms de joueurs maintenant, y compris des noms que j'aurais voulu ne pas voir. Tellement que je me demande comment je vais faire pour les modérer.
Tout tourne sur le même VPS hébergé chez OVH. J'ai un cœur et 2 GB de ram. C'est la même machine qui fait tourner le business, le serveur de jeu, le serveur de jeu de la version précédente, un autre business pour les tests, un autre serveur de jeu pour les tests, et mon site perso. La charge est quasi nulle, d'après le monitoring OVH le pic de CPU sur l'année doit être à 8%. htop m'indique 1GB de ram consommée en ce moment mais il y en a la moitié pour le serveur de jeu de test qui a été compilé avec AddressSanitizer.
Le VPS me coûte 4,20 € par mois. Le jeu ne me rapporte rien. Ce n'est pas une façon imagée pour dire qu'il rapporte peu ; j'ai zéro achat et zéro don.
[^] # Re: Les questions qui fâchent
Posté par Luc-Skywalker . Évalué à 2 (+0/-0).
Merci pour les précisions.
"Si tous les cons volaient, il ferait nuit" F. Dard
Envoyer un commentaire
Suivre le flux des commentaires
Note : les commentaires appartiennent à celles et ceux qui les ont postés. Nous n’en sommes pas responsables.